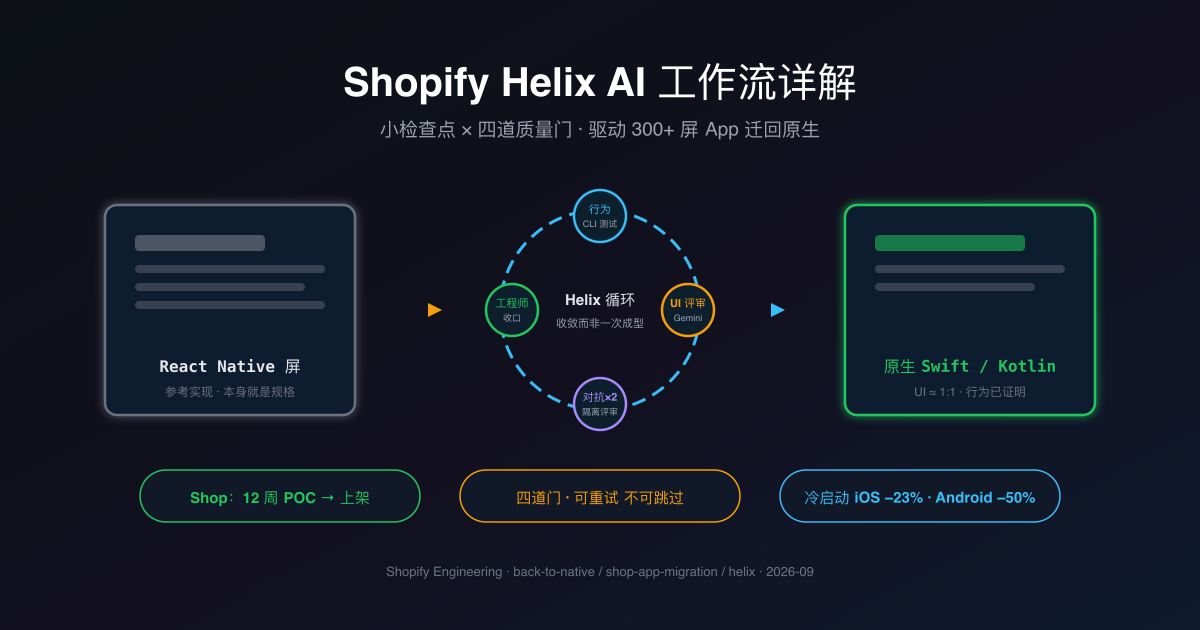
2020 年,Shopify 官宣全押 React Native;2025 年 1 月,官方博客还写着 RN 的未来一片光明(Five Years of React Native at Shopify)。到 2026 年 9 月,剧情反转:Shopify 宣布把旗下全部移动 App 迁回 Swift 与 Kotlin 原生,并首次公开了支撑这次决策的内部工具 Helix——一套让 LLM 承担大规模重写、同时保证代码”能发布”的工作流。迁移的来龙去脉见官方《Native is now the future of mobile at Shopify》;真正值得逐段拆的是 2026-09-21 发布的《Helix: The internal tool powering our Shopify app’s native migration》(作者 Talha Naqvi)。
Helix 最重要的主张只有一句话:不追求 LLM 第一次输出正确,只要求错的版本无法往前走。它把一个屏幕的迁移拆成小到一眼可审的检查点,用四道质量门逐个把关,再把每一条评审反馈写进记忆,让循环越跑越自主。本文基于 2026-10-08 核验的三篇 Shopify Engineering 官方文章(back-to-native、shop-app-migration、helix),先拆背景与机制,再看实测成绩单,最后给出我认为可以搬进自己工作流的四点启示。
核心要点
- Helix 的核心不是更强的模型,而是一个收敛循环:把屏幕拆成小检查点逐个构建,每个检查点必须通过行为测试、UI 视觉评审、两轮上下文隔离的对抗评审与工程师审批,才能 commit 进入下一个。
- 评审是门禁不是建议:任何一道门失败都可以无限重试,但 agent 无权以”我觉得够好了”跳过;工程师的反馈同时用于修复当前检查点与改进后续所有检查点。
- 多模型按能力分工:编排器用 GPT,UI 评审用 Gemini——UI 等价性不靠规格说明也不靠像素 diff,靠”先渲染、再看见差异、再修复”的收敛过程逼近 1:1。
- 实测成绩单来自 Shop App:AI 辅助下 12 周从概念验证到应用商店上架,冷启动 iOS 下降 23%、Android 下降 50%,崩溃会话率降至 1/10(0.5% → 0.05%),Android 包体缩小 37.2%。
一、背景:为什么把 300 多个屏幕重写一遍
Shopify 从 2021 年就在用 LLM 辅助开发(比 ChatGPT 发布早一年),到 2025 年底,团队发现 agent 带来的变化不再是”写代码更快”,而是动摇了 2020 年那个 RN 决策的核心假设:**”构建两次”不再等于”双倍工作量”**。官方的验证方式很直接——agent 可以拿 iOS 版本当参考在 Android 上实现功能(反之亦然),可以帮工程师快速上手主栈之外的平台,还可以通过共享的规格、测试与评审检查点大幅压缩维持双端对齐的成本。React Native 的核心收益(写一次、两端跑)被 agent 稀释了,而原生贴近平台能力与第一方工具链的优势还在,天平于是反转。
路径选择上,这次他们放弃了渐进式迁移(brownfield),选了推倒重建(greenfield):原型验证显示借助 agent 的重建速度远超从前,而干净的地基可以让新 App 按最佳方式组织,不必背着旧约束走。Shop App 先行:一名工程师花一周与 coding agent 合作,把尽可能多的 RN 界面移植成 SwiftUI 原生界面(产物达不到可发布,但证明了逐功能对齐的迁移可行);随后 6 人核心组搭起原生地基并实现主用户旅程,各特性团队中途加入补齐自己的领域。从概念验证到全原生 App 在应用商店上架,总共 12 周。
真正的大头是 Shopify App——旗下最大 App,300 多个屏幕,外加桌面与锁屏小组件、Apple Watch 应用、表盘复杂功能和 Siri 快捷指令,迁移已在进行中,计划年内发布。官方明确排除了”直接把 LLM 指向 RN 仓库一次性翻译”这条路,back-to-native 原文说得很不客气(译文):”即使你让它先尽可能收集信息、冻结成规格和任务文件再实现,最终得到的也是大量不可维护、无法发布的代码。”防止这种 AI 垃圾代码(slop)的答案,就是 Helix。
二、Helix 的循环:把”第一次就对”换成”必须收敛”
Helix 是什么?原文定义:一套工具与技能,帮助 LLM 从 React Native App 迁移特性与屏幕,同时遵循一套为新原生 App 专门设计、约束很强的架构。它与常见 one-shot 工具的区别,官方这段话说得很清楚:大多数工具尽可能收集信息,转成规格与任务文件,把整个功能实现出来,祈祷第一次结果就能用——工程师拿到一大坨代码,所有测试工作还都留给他。Helix 反着来:不期待第一次输出正确,把工作拆开,边走边从工程师身上学习,每答对一步就自动化更多,目标是把工程师加速到过去不可能的速度,同时保住质量。
支撑这个循环的是两个刻意的设计决策,都在”把人的注意力当稀缺资源”这个前提下。
第一,检查点小到一眼可审。迁移从现有 RN 代码和正在运行的 App 出发,工程师选定目标(整个屏幕或单个子屏幕),Helix 把它切成复杂度递增的检查点:第一个通常是屏幕骨架,第二个是一个刻意挑得很小的区块,后面的检查点只在前面的决策通过评审后才变大。每个检查点的描述只有几个词——这是故意的。原文的逻辑值得整段记住(译文):”在这个阶段,工程师只需要判断序列是否合理。没人能有效评审一堵由生成文本砌成的墙。我们宁可给对方一个能做的决定,而不是十页会被略读的文字。”
小检查点还有第二个作用:塞得进小上下文窗口,让 agent 直接去读参考代码里相关的部分,而不是靠一份巨大的规格文件或任务清单来”代表”代码——参考实现本身就是规格(The reference is the spec)。这在工程上是个反直觉但很划算的选择:与其花 token 维护一份注定过时的中间产物,不如让 agent 随用随读唯一可信的源头。另外,一个子代理会阅读参考代码,为每个检查点生成测试用例——按集成测试的粒度、从用户视角描述功能,并主动挖掘 happy path 之外的边界情况。这些用例稍后会成为第一道门的”通过标准”。
第二,门禁严到未证明不能过。 这是第三节的全部内容,这里先给循环的完整成绩对比:
| 维度 | 常见 one-shot 工具 | Helix |
|---|---|---|
| 工作投入 | 前期收集信息 + 一次性全量实现 | 分散到每个检查点的迭代里 |
| 工程师拿到的 | 一个巨大且高度不确定的 diff | 一串已通过验证的小 commit |
| 反馈时机 | 全部压在最后(评审时才发现问题) | 前移到最早有用的时点 |
| 评审负担 | 横跨行为、视觉、双平台、架构 | 每次只看一个一眼可判的决定 |
| 后续走向 | 靠人补救 | 反馈入记忆,循环越跑越自主 |
三、四道质量门:评审是门禁,不是建议
Helix 为每个检查点规定了四道按序执行的门。任何一道失败,agent 拿着反馈修复实现、重跑检查;可以无限次重试,但无权以”结果够好了”为由跳过失败的检查。”Reviews are gates instead of advice”(评审是门禁,不是建议)这个小节标题,是全文我最喜欢的一句。
Gate 1 行为:CLI 让 agent 在截一张图之前迭代几十次
Helix 的 CLI 暴露与 App 完全相同的屏幕状态与动作——比如首页会暴露分析数据与跳转到其他部分的动作。agent 分析参考 App 如何工作,复刻实现,然后通过 CLI 行为测试验证功能;检查点生成的那批测试用例在这里定义了什么叫”proven”,每一条相关用例都必须通过。关键在速度:CLI 不需要模拟器,这个循环非常快,agent 可以在截第一张图之前把行为迭代几十次。back-to-native 里交代了这个设计的来由——他们的架构原则是业务逻辑与 UI 彻底解耦、能在桌面 headless 运行,再通过 CLI 暴露给 agent。此前 agent 靠无障碍树或截图驱动模拟器,改代码只要几秒、验证一次却要几分钟,”模型再强也没用,如果它不能快速验证自己的工作”。
Gate 2 UI 评审:不指定视觉规格,让系统”看见”错误
这是原文称之为”Helix 最有意思的部分、输出接近 1:1 的主要原因”的一道门。它解决的问题是:UI 等价性几乎无法规格化——人一眼就能看出标题太小、分隔线太深、图标差一点,但这些细节几乎从不出现在 prompt 里;像素 diff 也不可行,因为两套 UI 框架不会产出字节级相同的输出。
Shopify 在教 agent 驱动模拟器时发现,当前 Gemini 模型对这类问题有很好的空间感知,能捕捉边距、留白这类 UI 细微差异并估计偏差,于是围绕它建了一道门:编排器(GPT)捕获实现与参考两张处于相同状态的截图,让 Gemini 扮演一个完美主义设计评审员,检查结构、间距、对齐;字号按截图尺寸的比例判断,所以文字过大过小也能被识别。Gemini 必须列出找到的每一处差异,各附严重度与屏幕位置;凡是能用代码修复的视觉差异,默认按 blocker 处理。
两个配套机制保证了这道门不会误伤:一是 INVALID 标记——如果编排器送来的两张截图状态不一致(比如一张是未履行订单、一张是已履行订单),Gemini 会把本次比较标为 INVALID,编排器把两个 App 调到同一状态再比;二是范围随检查点增长——骨架期的检查点只要求对比导航栏和标题,因为参考 App 是完整屏幕而新 App 还什么都没有。这段设计的洞察我愿意原样搬用:第一次渲染不需要完美,系统”能看见”哪里错了、描述它、定位它、并要求再试一次——这比在动手实现之前把每个视觉细节都写进规格可靠得多。
Gate 3 对抗评审:代码好不好,两个”陌生人”说了算
行为对、看着像,代码本身仍可能很差,这道门就是为此存在的。前提是 Shopify 为新 App 设计了一套 agent 友好、且彻底文档化的架构——正是这份文档让对抗评审变得可执行。两个互相独立、上下文隔离的评审 agent 对照这份架构检查新代码(UI 代码有自己单独的指南),每个发现都必须修复;修复后受影响的测试重跑,如果可见的部分变了,UI 评审门也重跑;然后两位评审再看一遍改过的代码,循环直到两个评审都批准。上下文隔离是这道门的设计要点:评审者不与实现者共享上下文,减少”自己审自己”的偏袒,评审的依据是文档化的架构标准而不是评审者的感觉。
Gate 4 工程师收口:反馈走两条路,一条修当下,一条喂未来
最后由工程师看代码和运行中的 App,判断结果是否符合预期。他的反馈去两个地方:agent 修复问题并重跑门禁;Helix 把反馈记入记忆,用来改进之后每一个检查点。这个记忆让自主性随迁移推进而增长:早期检查点获得更多工程师关注(不确定性高,已积累的已批准工作少),随着批准的代码与反馈累积,后面的检查点可以少一些监督,工程师也可以选择自主模式,让某些检查点直接跳过审批。每个检查点都以一次 commit 结束,大多数工程师从这里开分支、提 PR。
到这里,一个检查点到达工程师手里时已经状态良好:UI 与参考几乎 1:1,代码遵循指南,行为被测试证明——这是循环强制出来的,不是模型自觉。对工程师的价值在于:one-shot 工具把所有工作压到最后,一个人评审一个横跨产品行为、视觉保真、双平台与架构的巨大 diff;Helix 把反馈移到最早有用的时点,重复实现、跑检查、回应评审者这些活儿交给 agent,工程师专注范围、产品判断和品味。
四、自主运行,以及迁移之外的通用性
门禁架构让 Helix 可以安全地放手。默认工程师审批是强制的,但可以改变:要求它一口气完成接下来三个检查点,或者完全跳过审批,它能连续工作几个小时甚至整夜。而且没人在看的时候,门禁不会放松——每个检查点仍然要证明行为、通过 UI 评审、说服两位对抗评审,才能开始下一个。迁移还能并行:Helix 不限于一次一个屏幕,多个屏幕可以同时进行、各自通过自己的门收敛。自主运行结束后,工程师面对的不是一个巨大 diff,而是一串已提交的检查点,每个都带证据:存档的 UI 评审、通过的测试、评审结论。
这个循环也不只服务迁移。官方明确说这个循环没有任何一步是迁移专属的:做新功能时,可以把设计稿和产品文档当参考走同样的流程;架构迁移和重构用同样的检查点+门禁策略;纯逻辑改动跳过 UI 评审门即可。换句话说,Helix 贡献的是一个可复用的工程框架,迁移只是它的第一个应用场景。
原文的收尾一句话值得当作这篇文章的题眼(译文):”我们不再为完美的第一次尝试而优化,而是为可靠的收敛而工作。一次尝试允许出错;但在它不再出错之前,不允许发布。“(原文:”An attempt is allowed to be wrong. It is not allowed to ship until it isn’t.”)
五、成绩单:Shop 迁移的实测数据
需要先说明口径:Helix 本身目前没有公布量化指标,下一节的数据来自 Shop App 的 12 周迁移——它发生在 Helix 产品化之前(当时用的是 Pi coding agent 的扩展工作流加 Tardis 调试工具,可以视为同一套思路的前身),但足以验证”agent 辅助原生重写不牺牲质量”这条路线。
完整成绩单如下(全部来自官方实测,iOS 冷启动为点击图标到首页信息流可见的时间):
| 指标 | React Native | 原生 | 变化 |
|---|---|---|---|
| iOS 冷启动 | 3,200 ms | 2,466 ms | −23% |
| Android 冷启动 | 4,433 ms | 2,233 ms | −50% |
| 会话稳定性 | 99.5%+ | 99.95%+ | 崩溃会话率降至 1/10 |
| Android 包体 | 293 MB | 184 MB | −109 MB(−37.2%) |
| iOS 包体 | 67 MB | 68 MB | +1 MB(+1.5%) |
| Android 构建时长 | — | — | 约降 75% |
| Android 信息流滚动 | — | 120 FPS | Pixel 实测,几乎未做优化 |
这份成绩单的另一面同样重要:迁移必须对用户无感——保持登录态、推送不中断、埋点事件与下游系统依赖的上下文原样保留,同时趁机下线了部分屏幕、简化了另一些。
还有一段值得引用的诚实总结:原生专长依然重要,生成的代码可以满足功能需求,却仍可能引入重复代码、架构漂移或性能问题;仓库级指引、lint、测试、静态分析、性能检查与代码评审依然在岗。
迁移期间的一个工作习惯变化值得留意:他们不再是一个人改代码、跑起来、迭代,而是在多个 worktree 里并行跑多个 agent 会话,给 agent 明确的任务、维护快速构建与测试循环、频繁评审变更。Shop 时代的 Pi 扩展里,子代理分工检阅 RN 源码、记录行为、准备平台方案、实现、评审 parity,而且计划接受与内容 hash 绑定——改了计划,前一次接受即失效。
六、工程判断:四点可迁移的启示
Helix 不开源,官方说后续会继续分享 Helix 与 agent-addressable architecture 的细节。但拆完机制后,我认为有四件事不依赖 Helix 本身,任何团队的 agent 工作流都能复制:
我们的判断: Helix 真正的突破不在模型,而在把”质量标准”从评审意见变成了可执行的门禁程序——这件事在开源工具链上就能做,只是大多数团队还把 agent 当”生成器”而不是”被门禁约束的执行器”。
1. 反馈前移,门禁前移。 把质量标准写成”过不了就不能前进”的门,而不是写进评审意见里等人看。这和我拆解 SkillOpt 时的结论完全同构——那边是”验证门控让被拒编辑不伤分”,这边是”四道门让坏检查点不前进”(见《从手写 SKILL.md 到自动训练:用 SkillOpt 优化一个代码评审技能》)。两者的共同底层逻辑:对 agent 的信任不靠它自称多好,靠每一格的验证记录。
2. 为 agent 设计接口,而不只是为人。 业务逻辑 headless、CLI 毫秒级暴露状态与动作——agent 改代码以秒计,验证以分钟计的话,多强的模型都白搭。这是 Helix 第一道门能跑起来的物理基础,和我们在 Android CLI 与 Android Skills 实践里把设备操作收敛成可脚本化命令是同一个方向:接口先为可验证性服务,人机共用只是顺带的收益。
3. 视觉等价靠收敛,不靠规格。 “先渲染、再看见差异、再修复”之所以比”把每个视觉细节写进 prompt”可靠,是因为视觉本质上是感知问题不是描述问题。Gemini 当评审员、字号按截图比例判断、差异必须附位置与严重度——这套做法可以直接搬进任何 UI 迁移或 UI 回归场景,替代那些永远维护不完的”视觉 checklist”。
4. 行为用测试证明,质量用对抗评审兜底。 测试用例在实现之前由独立子代理从参考代码生成(含 happy path 之外的边界),这让”proven”有了客观定义——这与《AI 生成的单元测试:70/20/10 测试金字塔怎么落地》里”先定可验证标准再谈生成”的结论互相印证。而上下文隔离的双评审,比单模型自评可靠得多:评审者不知道实现者的思路,只对照文档化架构说话。工具链选型上这同样成立,Codex 与 DeepSeek harness 的对比里我们已经见过:harness 的评审与执行隔离能力,比模型榜单排名更影响产出质量。
落到最小可行版本:小检查点(一眼可审)+ 确定性验证(测试或可执行的评审 rubric)+ 独立评审者(上下文隔离)+ 反馈记忆(会话摘要、AGENTS.md 或技能文件皆可)。四件事都不需要 Helix,但都要求把 agent 工作流当工程系统来设计,而不是当更快的打字员。
FAQ
Helix 开源了吗?现在能用上吗?
没有。Helix 是 Shopify 内部工具,官方没有公布开源或商用计划,只承诺”继续分享学到的东西”。但它的循环四要素(小检查点、确定性验证、独立对抗评审、反馈记忆)不依赖任何专有工具,用 Claude Code、Codex 等通用 agent 加自定义技能与脚本即可仿造一个缩小版。
Helix 只能用于 React Native 迁移吗?
不是。官方明确说循环里没有任何一步是迁移专属的:新功能开发可以把设计稿与产品文档当参考走同样流程;架构迁移与重构用同样的检查点加门禁策略;纯逻辑改动跳过 UI 评审门即可。参考实现换成设计稿,循环照样成立。
为什么用 Gemini 做 UI 评审,而不是像素 diff 或写更详细的规格?
两个原因。其一,UI 等价性几乎无法规格化:人一眼能发现的细节(标题偏小、图标差一点)几乎从不出现在 prompt 里,规格永远追不全。其二,像素 diff 不可行:两套 UI 框架不会产出字节级相同的输出,逐字节比较只会产生海量噪声。Shopify 实测发现当前 Gemini 模型对边距、对齐这类空间差异有很好的感知能力,能按截图尺寸比例估计字号偏差,于是让它逐条列出差异、附严重度与位置,代码可修的默认按 blocker 处理。
自主模式下没人盯着,质量会下降吗?
按官方描述不会,因为门禁不依赖”有人在看”:每个检查点仍必须通过行为测试、UI 评审与双对抗评审才能进入下一个,可无限重试但不可跳过。自主模式的差异只在最后一级——工程师审批可以整段跳过,而它交付的仍是一串带证据的 commit(存档的 UI 评审、通过的测试、评审结论),评审负担从”过程内”移到了”事后抽查”。
结语
Helix 值得拆解,不是因为它有多神秘——检查点、测试、评审、commit,每个零件都不新鲜——而是因为它把零件组装成了一个不完美的尝试无法前进的系统,并公开了作业方式。对正在 AI 辅助开发里和”能跑但不能发”搏斗的团队,四件事的优先级高于换更强的模型:把大任务切成一眼可审的小检查点;让每一步都有可执行的通过标准;让评审独立于实现;把反馈沉淀下来喂给后续每一步。模型的能力曲线不受我们控制,但门禁的严格程度完全由我们自己决定。
三篇原文:Helix(2026-09-21,Talha Naqvi)、Native is now the future of mobile at Shopify(2026-09-10,Mustafa Ali)、Migrating Shop app from React Native to native(2026-09-10,Max Da Silva / Jason Kim / Quique Fagoaga)。关于”评审门禁”的算法侧版本,见上一篇:用 SkillOpt 优化一个代码评审技能。