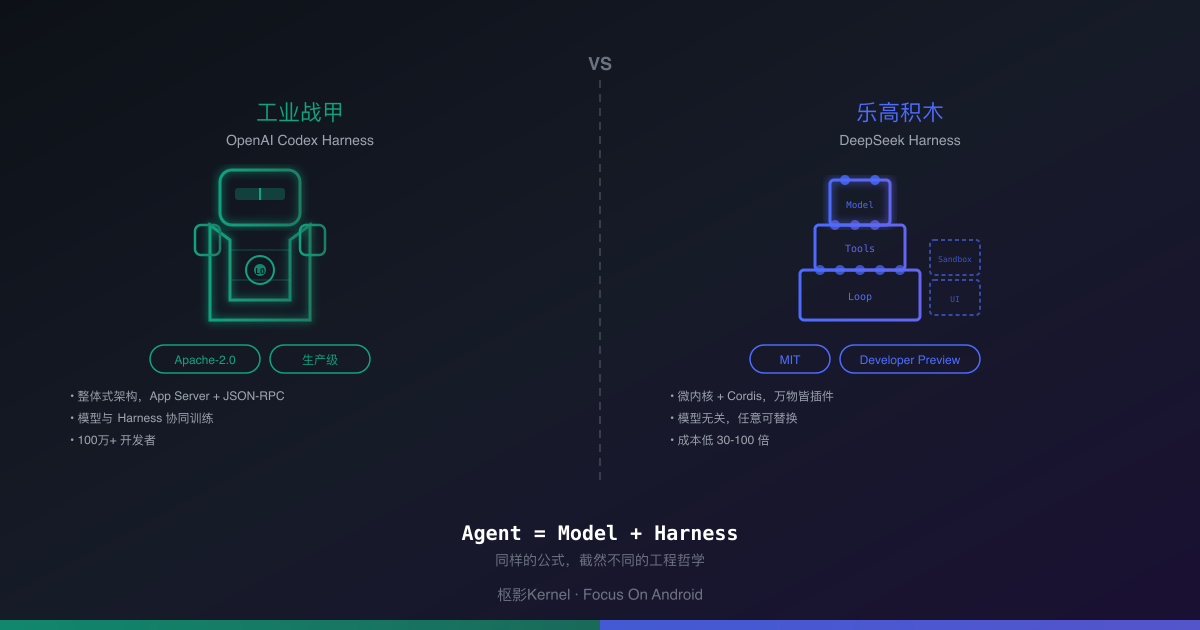
2026 年,”Agent = Model + Harness”这个公式已经成为行业共识——模型提供智能,harness 提供模型自身无法完成的一切:任务循环、工具访问、沙箱、审批门、状态管理。但同样的公式,可以推导出截然不同的工程哲学。
8 月,两个重磅 harness 几乎同时开源。8 月 13 日,DeepSeek 发布 DeepSeek Harness(MIT,Developer Preview),4 天内 GitHub star 突破 14 万(GitHub API 查询,访问于 2026-08-17)。8 月 20 日,OpenAI 开源 Codex Harness(Apache-2.0),这是驱动 Codex CLI、IDE 扩展、Web App 和 macOS App 的同一套运行时,已有超过 100 万开发者在使用(AI Digester,2026-02)。
一个是经过大规模验证的工业级整体式战甲,一个是万物皆可拼装的微内核乐高积木。本文从架构哲学、模型关系、扩展模型、生产就绪度四个维度深度对比这两条路线。
Key Takeaways
- 架构哲学根本对立:Codex Harness 是整体式架构(App Server + JSON-RPC 2.0,Thread/Turn/Item 协议),追求紧密集成与生产稳定性;DeepSeek Harness 基于 Cordis 微内核,”万物皆插件”——模型、工具、循环、沙箱、UI 全部可替换。
- 模型关系是核心分歧:Codex 的模型与 harness 协同训练,工具使用内化到模型行为中;DeepSeek Harness 模型无关,任何模型可通过插件接入,靠框架适配而非训练对齐。
- 成熟度与成本是互补取舍:Codex Harness 生产级稳定、100 万+开发者验证,但绑定 OpenAI 生态;DeepSeek Harness 是 Developer Preview(明确警告 breaking changes),但运行成本据分析低 30-100 倍。
- 选型不是二选一:DeepSeek Harness 甚至能把 Codex 或 Claude Code 作为子进程驱动——两条路线在实践中可以组合,而非互斥。
两个 Harness 的诞生背景与核心定位
理解一个 harness 的设计选择,要先看它从哪里来。两者的出身决定了截然不同的工程优先级。
OpenAI 的 Codex Harness 不是凭空设计的框架,而是从真实的 Codex 产品中抽离出来的。OpenAI 工程师 Celia Chen 在 2026 年 2 月的官方博客中解释:Codex 存在于 Web App、CLI、IDE 扩展、macOS App 多个界面,它们底层跑的是同一套 harness。2026 年 8 月的开源,是把这套经过大规模验证的运行时开放给开发者自建 Agent。OpenAI 开发者体验工程师 Gabriel Chua 在 2 月进一步澄清:Codex 的模型是在与 harness 共存的环境下训练的,工具使用、执行循环、验证逻辑被内化到了模型行为中。
DeepSeek 走了另一条路。DeepSeek Harness 不是从某个成熟产品中剥离的,而是基于 Cordis 元框架从零构建的插件化运行时。The New Stack在 8 月 13 日的报道中指出,这是一个 Node.js 驱动的 harness,核心设计原则只有一句话:”Everything is a plugin”。模型适配器、工具注册表、Agent 循环本身都是可替换的插件。它的定位明确写在仓库里:Developer Preview,”THERE WILL BE COMPATIBILITY-BREAKING CHANGES”。
这个出身差异是理解后续所有架构分歧的钥匙:Codex Harness 优化的是”让模型在固定运行时里发挥最好”,DeepSeek Harness 优化的是”让运行时适配任何模型”。
关于 端侧 AI 应用架构参考 的更多内容,可参阅此前的 AI Edge Gallery 架构解析一文。
架构哲学:整体式 vs 微内核插件化
两个 harness 最根本的分歧在于架构哲学:是造一套精密咬合的整体式战甲,还是搭一盒可以随意拼装的乐高积木?
Codex Harness:精密的整体式战甲
Codex Harness 的架构核心是 App Server——一个基于 JSON-RPC 2.0 的双向通信服务器。根据 OpenAI 官方文档和技术深度分析,它用 Thread / Turn / Item 三层抽象管理对话状态:Thread 是一次会话,Turn 是一轮交互,Item 是其中的具体事件(工具调用、审批请求、流式输出)。
这个设计的特征是紧密集成。App Server 统一管理认证、对话历史、审批流程、事件流,所有 Codex 界面(CLI、IDE、Web、macOS)都通过同一个 JSON-RPC 接口与它通信。模型推理、工具执行、沙箱隔离、循环终止这些核心逻辑被封装在 harness 内部,对开发者暴露的是结构化的 API 而非可替换的组件。
Agent 循环本身是 harness 的核心:接收用户输入 → 构造 prompt → 调用模型 → 解析响应(通常是工具调用)→ 执行工具 → 把结果追加到 prompt → 再次调用模型,直到模型产出最终回复。这个循环不可替换,但经过高度优化——prompt 缓存实现线性而非二次性能、上下文窗口自动压缩、无状态请求处理满足 Zero Data Retention 合规。
DeepSeek Harness:万物皆插件的乐高积木
DeepSeek Harness 基于 Cordis 元框架,采用微内核架构。InfoQ 在报道中描述:运行时组件作为隔离的、可互换的插件运行,而非单体系统模块。
“万物皆插件”不是夸张。根据官方文档和多个技术分析,以下全部是可替换的插件:
- 模型适配器(Models):DeepSeek V4、Claude、GPT、Qwen、任意 OpenAI 兼容端点
- 工具(Tools):Shell、编辑器、搜索、浏览器、测试运行器、包管理器
- 技能(Skills):可组合的任务能力单元
- 会话(Sessions):以 append-only 事件日志存储,可追溯、恢复、fork、搜索、回放
- 沙箱(Sandbox):执行隔离环境
- 存储(Storage):持久化后端
- 循环(Loop):Agent 执行循环本身
- 编排(Orchestration):多 Agent 协调
- UI:浏览器界面
连 Agent 循环都能替换,这是与 Codex 最本质的区别。DeepSeek 的思路是:把”Agent 怎么运行”这个问题也交给开发者决定,框架只提供拼装机制。
工程含义
整体式的好处是一致性和可预测性。所有 Codex 界面行为一致,因为跑的是同一套循环逻辑;模型知道自己会被怎样调用,因为训练时就见过这个 harness。代价是灵活性受限——你不能把 Agent 循环换成另一种范式,也不能把 GPT-5.6 换成 Claude 而期望同等表现。
微内核的好处是自由度和可组合性。你可以用 DeepSeek V4 做推理、用自定义循环做编排、用自己的沙箱做隔离。代价是一致性和稳定性——插件之间组合可能产生预期外的交互,Developer Preview 状态意味着 API 随时可能变。
模型关系:协同训练 vs 模型无关
架构哲学的分歧在”模型与 harness 的关系”上体现得最尖锐。这不仅是技术选择,更是产品战略。
Codex:模型与 Harness 协同训练
OpenAI 的 Gabriel Chua 在 2026 年 2 月明确阐述了一个关键事实:Codex 的模型不是独立训练后”接入”harness 的,而是在与 harness 共存的环境下训练的。工具使用模式、执行循环结构、验证逻辑被内化到了模型的权重中。
这意味着 Codex 模型”知道”自己会被怎样调用。当它决定调用一个工具时,它生成的调用格式与 harness 的解析逻辑是训练时对齐的,不是运行时适配的。这种协同训练减少了格式不匹配、工具误调用的概率——模型不是在”猜”harness 想要什么,而是”记得”。
代价是模型锁定。Codex Harness 虽然开源了,但它的设计假设了一个与之协同训练的模型。把 Claude 或 DeepSeek V4 接入 Codex Harness 理论上可行,但模型不会享受协同训练带来的行为对齐优势——它需要靠 prompt 工程弥补训练时缺失的 harness 感知。
DeepSeek:模型无关,插件适配
DeepSeek Harness 走了相反的路:harness 不假设任何特定模型。根据官方文档和DataCamp 教程,它通过 llm-pi-ai 插件支持 DeepSeek V4、Claude、GPT、Qwen、Bedrock、Vertex、Azure 以及任何 OpenAI 兼容端点。模型适配完全由插件处理,harness 核心不关心你用什么模型。
这种设计的好处是选择自由。你可以用最便宜的 DeepSeek V4-Flash 做日常编码,用 Claude Opus 做复杂推理,用本地 Qwen 做隐私敏感任务——同一个 harness,换插件即可。根据分析,DeepSeek V4-Flash 的运行成本约为竞品的 1/30 到 1/100(Medium 技术分析 与 Atlas Cloud 定价交叉验证,2026-08)。
代价是没有协同训练红利。模型需要靠 prompt 和插件 schema 理解 harness 的工具格式,而非训练时内化。这在当前模型能力下大多可行,但在边缘场景可能出现格式不一致。
关于 AI Agent 接入可验证开发流程 的实践,可参阅此前的 Android CLI 文章,其中也涉及 Agent 与工具系统的协作模式。
扩展模型:SDK 三件套 vs 插件生态
开源 harness 的价值在于让开发者在其上构建自己的 Agent。两个 harness 提供了截然不同的扩展路径。
Codex:三种集成深度
OpenAI 在 8 月 19 日发布 Codex 平台声明后,explainx.ai 的分析文章中把 Codex 定位为平台,提供三种集成方式:
- **
codex exec**:CLI 工具,最轻量集成。在终端运行 Codex Agent,适合脚本化任务和 CI/CD 流水线。 - Codex SDK:编程式集成,在应用代码中调用 Agent 能力。适合需要自定义流程控制的场景。
- app-server:最深度集成,直接运行 Codex App Server,获得完整的 Thread/Turn/Item 协议、审批流、实时事件流。适合构建 IDE 扩展、自定义 Agent 平台、自动化代码审查系统。
这三种方式是同一个 harness 的不同暴露层级,开发者按需要的控制粒度选择。app-server 的 JSON-RPC 协议让深度集成成为可能——你可以监听 Agent 的每一个工具调用事件、插入审批门、实时流式输出进度。
DeepSeek:插件生态与一键启动
DeepSeek Harness 的扩展方式是写插件。任何能力——新的模型、工具、技能、沙箱、UI——都以插件形式接入。根据 The New Stack报道,发布数小时内就出现了大量社区插件。
启动门槛极低:一条 npx @deepseek-ai/dsh web 命令即可启动带浏览器 UI 的本地 Agent。开发者可以在此基础上替换任意插件,或编写新插件扩展能力。会话状态以 append-only 事件日志存储,这意味着 Agent 的每一次工具调用、每一次 prompt、每一次 token 消耗都可追溯、回放、fork——这是 DeepSeek 把 R1 “开源思考过程”理念上移到 harness 层的体现。
一个关键差异:DeepSeek 能驱动 Codex
Winder.ai 的对比分析指出了一个出人意料的事实:DeepSeek Harness 能把 Claude Code 或 Codex 作为子进程驱动。这意味着两条路线在实践中不是互斥的——你可以用 DeepSeek Harness 做编排层,把 Codex 或 Claude Code 作为底层执行 Agent。
生产就绪度与经济性
架构再优雅,最终要看能不能用、用得起。两个 harness 在这两个维度上呈现互补的取舍。
成熟度对比
Codex Harness 是生产级的。它驱动着 OpenAI 官方的 Codex 产品线,被超过 100 万开发者使用,经历了真实的大规模验证。Agent 循环的每一个环节——prompt 缓存、上下文压缩、无状态请求、多轮一致性——都经过生产打磨。
DeepSeek Harness 是 Developer Preview。仓库 README 明确警告会有兼容性破坏性变更。xcloud.host 的对比给出的判断是:”OpenCode 是 2026 年更安全的日常工具;DeepSeek Harness 是更具架构意义的方案。如果你每天写代码需要稳定产出,先用 OpenCode;如果你在构建别人要运行的 Agent 基础设施,dsh 是有趣问题所在的地方。”
经济性对比
经济性是 DeepSeek 的核心攻击点。根据分析,DeepSeek V4-Flash 配合 DeepSeek Harness 的运行成本约为竞品的 1/30 到 1/100。具体来说,Atlas Cloud 的定价显示 DeepSeek V4-Flash 为每百万输入 token $0.14、输出 token $0.28,对比 GPT-5.6 或 Claude Opus 的定价,成本差异显著。
这对于需要大规模运行 Agent 的场景——CI/CD 中的自动代码审查、批量 issue 分诊、大规模重构——是决定性的。在这些场景下,Agent 可能需要运行成千上万次,30 倍的成本差异意味着能用和用不起的区别。
下面的视频是 100 小时实测对比,直观展示了 DeepSeek Harness 在速度、质量、成本上的实际表现:
选型决策:什么时候用哪个
没有绝对的好坏,只有场景匹配。以下是基于前文分析的选型矩阵。
选 Codex Harness 的场景:
- 你的团队已经在 OpenAI 生态内,使用 GPT-5.6 系列模型
- 需要生产级稳定性,不能容忍 breaking changes
- 要构建 IDE 扩展或深度集成的 Agent 平台(用 app-server)
- 重视模型与运行时的行为对齐(协同训练红利)
- 预算不是首要约束
选 DeepSeek Harness 的场景:
- 需要极致成本控制,大规模运行 Agent(30-100 倍成本优势)
- 要用非 OpenAI 模型(Claude、DeepSeek V4、Qwen、本地模型)
- 要构建自己的 Agent 基础设施,需要替换 Agent 循环或沙箱
- 能接受 Developer Preview 的不稳定性
- 要把多个 harness 组合使用(DeepSeek 做编排,Codex/Claude 做执行)
混合策略:根据 Winder.ai 的分析,DeepSeek Harness 能驱动 Codex 和 Claude Code 作为子进程。这意味着你可以用 DeepSeek Harness 做顶层编排(利用其插件化优势和低成本模型做任务分发),把 Codex 或 Claude Code 作为底层执行 Agent(利用其协同训练红利和生产稳定性)。这种组合在实践中可能是最优解——用乐高积木搭框架,在关键节点嵌入工业战甲。
关于 Android 端侧 AI 与 Agent 工具化框架 的更多内容,可参阅 AppFunctions 框架一文。
常见问题
Codex Harness 和 DeepSeek Harness 哪个更适合生产环境?
当前阶段,Codex Harness 更适合生产环境。它是从 OpenAI 官方 Codex 产品中抽离的成熟运行时,被 100 万+开发者验证,Agent 循环的每个环节都经过生产打磨。DeepSeek Harness 仍是 Developer Preview,明确警告会有 breaking changes,适合实验和插件开发,不建议 pin 到生产系统。
两个 Harness 能用同一个模型吗?
DeepSeek Harness 模型无关,可以接入 GPT、Claude、DeepSeek V4 等任意模型。Codex Harness 设计上与 OpenAI 模型协同训练,虽然技术上可能接入其他模型,但不会享受协同训练带来的行为对齐优势。两个 harness 都支持 OpenAI 兼容 API 端点。
DeepSeek Harness 真的比 Codex 便宜 30-100 倍吗?
成本差异主要来自模型而非 harness 本身。DeepSeek V4-Flash 定价约每百万输入 token $0.14,对比 GPT-5.6 或 Claude Opus 的高定价,在需要大规模运行 Agent 的场景下成本差异可达 30-100 倍。但若两个 harness 跑同一个模型(如都接 DeepSeek V4-Flash),成本差异不大。更多 Agent 工具化实践 可参阅相关文章。
“万物皆插件”和”SDK 三件套”哪个扩展性更强?
从理论上说,DeepSeek 的插件化扩展性更强——连 Agent 循环都能替换。Codex 的 SDK 三件套提供的是层级式的集成深度,组件本身不可替换但暴露了完整的控制接口。实践中,Codex 的方式更可预测(组件行为一致),DeepSeek 的方式更灵活(但组合复杂度更高)。
结论
工业战甲和乐高积木,不是谁替代谁的关系,而是两种截然不同的工程哲学在同一个公式下的展开。
回顾要点:
- 架构哲学:Codex 整体式(App Server + JSON-RPC,紧密集成,生产稳定);DeepSeek 微内核(Cordis + 万物皆插件,极致灵活,preview 状态)。
- 模型关系:Codex 协同训练(行为对齐,模型锁定);DeepSeek 模型无关(选择自由,无训练红利)。
- 成熟度与成本:Codex 生产级 + 100 万用户 + 高成本;DeepSeek preview + 14 万 stars + 低成本 30-100 倍。
- 组合可能:DeepSeek 可驱动 Codex/Claude Code 为子进程,两条路线在实践中可组合。
对于要在 Agent 基础设施上做技术决策的团队,判断标准其实很简单:如果优先级是稳定和开箱即用,选 Codex;如果优先级是成本和灵活性,选 DeepSeek;如果两者都要,用 DeepSeek 做编排层、Codex 做执行层。harness 层的竞争才刚开始,这两条路线会各自演进,也可能在某个交汇点融合——但理解它们今天的设计取舍,是做出正确选型的基础。