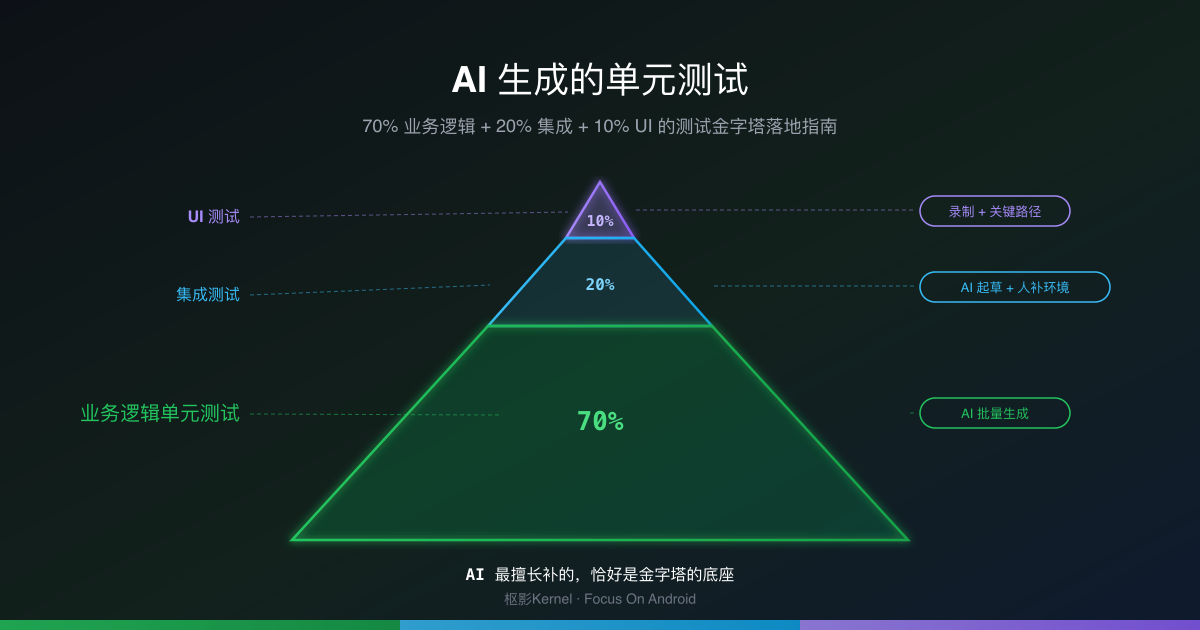
三年前我们在《Android单元测试实践》里写过 Google 官方建议的测试金字塔:小型测试(单元测试)占 70%,中型测试(集成测试)占 20%,大型测试(端到端)占 10%。这篇文章当时收到了不少反馈,但反馈里出现频率最高的一句话是:”比例谁都背得出来,项目排期里就是没人写。”
2026 年,这个问题有了新的解法,也带来了新的坑。解法是:AI 让生成单元测试的边际成本第一次趋近于零。坑是:很多团队的体验是 AI 一晚上生成了几百个测试,覆盖率涨了,线上缺陷却一个没少——因为生成的测试”看起来能过”,却在复读实现,而不是验证行为。
所以今天要回答的问题不是”AI 会不会写测试”,而是”怎么把 AI 的产出组织进一个可持续的测试体系”。本文给出一套完整落地路径:先用 CI 数据量出真实基线,再按 70/20/10 分配人机分工,最后用变异测试和门禁守住质量,附六周推进路线图。
Key Takeaways
- 70/20/10 仍是有效的资源分配框架,变的是实现方式:AI 让占大头的业务逻辑单元测试第一次可以低成本批量生产。
- AI 生成测试的瓶颈从”写”转移到了”验证”——Meta TestGen-LLM 经过层层过滤后仍有约 27% 的建议未被采纳,变异测试比覆盖率更能识别”假测试”。
- 集成与 UI 层 AI 只能辅助:起草用例矩阵、修复选择器;环境搭建与关键路径取舍仍由人决定。
- 先用 CI 数据建立基线,再按六周路线图滚动推进;度量缺陷逃逸率与变异分数,而不是测试数量。
测试金字塔没过时,过时的是”所有测试都手写”
70/20/10 这个比例出自 Mike Cohn 2009 年《Succeeding with Agile》里一个高响应力团队的真实分布,Google 把同样的结构写进了官方 Android 测试指南,作为小型 / 中型 / 大型测试的建议配比。金字塔的逻辑很朴素:沿着金字塔逐级向上,测试对真实用户场景的保真度越高,但运行越慢、维护越贵、越不稳定。单元测试毫秒级跑完、失败原因一目了然——Martin Fowler 的表述是”在一台还不错的机器上,你可以在几分钟内跑完成千上万个单元测试”(Practical Test Pyramid,2018);UI 测试则动辄分钟级、失败可能只是环境抖动。
AI 没有推翻这个结构,反而强化了它——因为大模型的能力剖面和金字塔恰好”同构”:
- 金字塔底层(单元测试):输入输出明确、无环境依赖、验证闭环极短(生成后编译跑一下就知道对错)。这正是 LLM 最擅长的”可快速验证任务”,错了可以立刻重来。
- 金字塔中层(集成测试):需要搭建数据库、网络、依赖服务的环境,AI 不了解你的测试基建,只能起草用例。
- 金字塔顶层(UI 测试):有状态、有时序、受渲染影响,一次失败可能是十几种原因,AI 无法自证对错,人工维护成本最高。
换句话说,AI 最擅长补的,恰好是金字塔的底座。这也是 70/20/10 在 AI 时代依然成立的原因:它把最多的量分配给了 AI 产出质量最高、验证成本最低的那一层。
这个判断的背景是:AI 辅助编码已经不是尝鲜。Stack Overflow 2025 年开发者调查显示,84% 的开发者正在使用或计划使用 AI 工具,专业开发者中过半每天使用;但任务级数据揭示了落差——“测试代码”是 AI 渗透最慢的任务之一:只有 17.9% 的开发者在这个任务上主要使用 AI,44.1% 明确不打算用(Stack Overflow 2025 开发者调查,2025-07,retrieved 2026-09-05)。Google Cloud 的 DORA 2024 年度报告从另一个角度敲了警钟:超过 75% 的受访者已在至少一项日常职责中依赖 AI,但 AI 采用率每提升 25%,交付稳定性估计下降 7.2%(DORA 2024 报告公告,2024-10-23,retrieved 2026-09-05)。产能上来了,质量体系没跟上,稳定性就买单。对工程团队来说,真正的问题从”要不要用 AI”变成了”用什么机制把 AI 的产出纳入质量体系”——而测试金字塔正好就是这个机制的骨架。
第一步:用 CI 数据量出真实分布,而不是拍脑袋定比例
读完这一节,你应该能得到一张三行的基线表:每一层测试有多少个、占多大比例、在 CI 里跑多久、flaky 率多少。没有这张表,后面所有的比例讨论都是空中楼阁。
需要收集三类数据,全部来自现成的 CI 产物:
- 各层测试数量与占比。Android 项目里,
testDebugUnitTest的 JUnit XML 在build/test-results/,connectedDebugAndroidTest的报告在 instrumentation 输出里;服务端项目看pytest --junitxml或 Maven Surefire 的 XML。注意 JUnit XML 是 XML 而非 JSON,jq 处理不了,聚合要用 xmlstarlet(命令在列表后)。 - 各层运行时长。直接读 CI 任务耗时:单元测试任务通常在秒级,instrumentation 测试任务通常在分钟级。这个差距本身就是金字塔存在的理由,也是后面说服团队的数据。
- flaky 率。统计”同一 commit 重跑后结果翻转”的用例占比。很多 CI 平台(如 GitLab 的 flaky test 检测、Buildkite 的 retry 事件)已经内置了这项数据。
以第 1 项的 Gradle 单元测试产物为例,xmlstarlet 一行就能列出每套件的用例数与失败数:
1 | xmlstarlet sel -t -m '/testsuites/testsuite' \ |
把结果整理成基线表(下表为示意数据,格式供参考):
| 测试层 | 数量 | 占比 | CI 时长 | flaky 率 |
|---|---|---|---|---|
| 单元测试(业务逻辑) | 120 | 15% | 40s | <1% |
| 集成测试 | 80 | 10% | 6min | 3% |
| UI / E2E | 600 | 75% | 45min | 12% |
(这张表是典型的”倒金字塔”现状:大量 UI 测试盖住了几乎没有单元测试的业务逻辑层——也是最常见的起点。)
作为对照,Google 官方文档建议的目标分布长这样:
关键判断:基线的意义是发现结构性缺失,不是精确凑出 70/20/10。如果你的现状是 15/10/75,要做的不是把 600 个 E2E 删掉,而是把新增测试的产能全部导向底层,让比例随时间自然回归。
这一步的验收标准有两个:拿到基线表,并且选定一个试点模块——业务逻辑密集、近期缺陷多、当前单元测试少的那个模块,作为第二步 AI 生成的主战场。
第二步:业务逻辑层(70%),AI 的主战场也是验证的主战场
这一节给出单测产线的完整闭环:哪些代码值得先做、怎么给 AI 下指令、怎么验证产出不是”假测试”。
先圈地:什么代码值得让 AI 写测试
优先级排序很明确:纯业务逻辑——UseCase / Interactor、ViewModel 与 Presenter 的状态逻辑、解析器与序列化、状态机、金额与权限计算、工具类。这些代码输入输出明确、无 UI 依赖、副作用少,AI 生成质量和验证效率都最高。UI 渲染、线程调度、框架胶水代码先放过。
关键动作:让 AI 按”行为”生成,而不是按”方法”复读
大部分团队用 AI 写测试的方式是选中一个类说”给它写单元测试”,得到的往往是把实现复述一遍的测试。有效的 prompt 应该强制 AI 先做行为分析。下面是可以直接用的模板:
1 | 为下面的 Kotlin 类生成单元测试。要求: |
区分”好测试”和”假测试”最直观的办法是对比同一函数的两种写法:
1 | // ❌ change detector:复读当前实现,实现错了测试也跟着"对" |
两个测试跑起来都可能是绿的,但第一种在需求变更时只会制造噪音,第二种才是资产。
证据:Meta 大规模试验告诉我们 AI 测试的真实水平
对”AI 生成的测试到底能不能用”这个问题,目前最有分量的一手证据来自 Meta。2024 年 2 月的论文《TestGen-LLM: Automatically Improving Unit Tests using Large Language Models》(arXiv:2402.09171)报告了在 Meta 真实代码库上的大规模试验:试验方式是对既有测试类做”过滤-推荐”式增量改进,模型推荐的测试用例中 75% 能正确编译构建,57% 能可靠通过,25% 提升了行覆盖率;经过构建、运行、覆盖等多重自动过滤后,仍有 73% 的建议被 Meta 工程师评审接受并合入代码库(Meta / arXiv,2024-02,retrieved 2026-09-05)。试验覆盖近 2,000 个测试类,其中约 11.5% 的类最终拿到了可直接合入的改进测试——对一次 test-a-thon 来说,这是一批纯增量的质量资产。
两个解读值得展开。第一,73% 的接受率是在机器过滤之后——如果跳过构建验证、运行验证、覆盖率比对直接把 AI 输出交给人工评审,实际效率会低得多,这正是后文质量门禁存在的原因。第二,这篇论文衡量质量用的是行覆盖率,变异分数提升被列为未来工作——连 Meta 都没有宣称”AI 生成的测试能提高缺陷检出能力”,所以覆盖率提升不等于测试变强,这个差距要靠变异测试来补(下文详述)。
验证闭环:变异测试是识别”假测试”的显微镜
覆盖率回答”代码有没有被执行”,变异测试回答”测试能不能发现代码错了”。pitest(Java/Kotlin)或 Stryker(JS/TS)会自动向业务代码注入突变(条件取反、返回值篡改),然后用你的测试套件去杀这些突变体——测试没杀死突变体,说明这条测试根本没在验证什么。Gradle 接入 pitest 只需要几行:
1 | // build.gradle.kts |
落地建议是变异测试只对业务逻辑层开启(范围对应金字塔的 70%),阈值从现实基线起步逐步收紧,不要一上来就追求 90%——变异测试的运行成本随代码量线性增长,全库开启会让 CI 无法忍受。
规模化:遗留代码怎么批量补测试
试点验证 prompt 模板之后,遗留代码的批量路径是:先用 AI 生成特征测试(characterization tests)固化当前行为——这一步的断言就是”现状快照”,目的是给重构兜底而不是表达预期;再由人工把高风险路径的特征测试升级为行为断言;最后才开始重构。这个顺序把”AI 写得快”和”人审得准”各自用在了刀刃上。Java 存量代码较多的团队也可以评估 Diffblue Cover 这类专门工具(vendor 宣称可批量生成可编译的 JUnit 测试,属厂商营销口径,选型时以自己仓库的实测为准)。
关于 JUnit、Truth、MockK 这些测试栈本身的选择依据,三年前那篇《Android单元测试实践》里有完整的对比,本文不再展开。
第三步:集成测试层(20%),人搭环境 AI 填矩阵
集成测试的成本大头在环境:数据库要用内存版还是测试容器、网络层要挡在 MockWebServer 后面、跨模块依赖要用测试双胞胎还是真实实现。这些决策 AI 帮不上忙——它不了解你的依赖注入拓扑和 CI 资源预算。
所以这一层的分工是:人搭骨架,AI 填矩阵。
人负责一次性搭好:Hilt 的测试模块、Room 的 in-memory 数据库、MockWebServer 或 WireMock 的桩服务、Testcontainers(服务端)、以及跑这些测试的独立 CI 任务(和单元测试分开,失败不阻塞合并)。
骨架就位后,AI 的任务是把它了解的组件契约展开成用例矩阵:
1 | 这是已经搭好的 OrderRepository 集成测试骨架(Room in-memory + MockWebServer)。 |
一句话定位 Robolectric:它让你在 JVM 上跑带 Android 框架的测试,严格说位于单元测试和真机集成测试之间,适合归入这一层管理,但别把它当 UI 测试的替代品。
第四步:UI 测试层(10%),克制是美德
UI 测试在金字塔顶端只有一个存在理由:验证用户关键路径真的能走通。它同时拥有三个”最”——最慢、最贵、最不稳定,所以配额只有 10%。
Google 自己的数据说明了为什么必须克制:其测试博客披露,内部约 1.5% 的测试用例存在某种程度的 flaky——按 Google 的体量约是 1.6 万个用例——为此专门建设了自动检测、隔离队列与自动归因修复体系(Flaky Tests at Google and How We Mitigate Them,2016,retrieved 2026-09-05)。UI 测试是 flakiness 的重灾区,而 flaky 测试的真正成本不是红,而是团队学会了对红色视而不见。
因此这一层的规则是:只盖关键路径——登录注册、下单支付、核心转化流程,一个 App 通常不超过 10 条。剩余的 UI 质量交给 Compose 语义测试和组件级快照。
AI 在这一层的三个真实用途(以及一个反模式):
- 生成与修复选择器、Page Object。UI 测试的维护大头是元素定位失效,AI 根据报错日志批量修复
testID/语义树查找,是目前收益最确定的应用。 - 解释失败。把 instrumentation 失败堆栈丢给 AI,让它区分”真缺陷 / 环境抖动 / 测试自身问题”,能显著缩短 triage 时间。
- 从 PRD 提炼冒烟清单。让 AI 读需求文档,列出”上线前必须走通的用户旅程”,人来裁剪。
- **反模式:让 AI”给整个 App 生成 E2E 测试”**。这等于把维护地狱自动化,生成的数量越多,弃用得越快。
1 | // Compose UI 测试:只盖关键路径,断言用户可见结果而非内部状态 |
质量门禁:别让 AI 把测试套件变成”全绿但没用的绿”
AI 批量生成测试之后,测试套件面临的最大风险不是少,而是假。三个反模式占了我见过的绝大多数问题:
| 反模式 | 典型表现 | 检测手段 |
|---|---|---|
| change detector(复读实现) | 断言值来自当前实现的输出;重构一次挂一片 | 变异测试杀突变体;评审时问”这条断言的业务依据是什么” |
| 覆盖率注水 | 无断言测试、assertNotNull 满天飞、行覆盖 90% 缺陷照逃逸 |
变异分数趋势;断言密度抽查 |
| mock 一切 | 所有依赖都是 mock,真实依赖的行为漂移无人知晓 | 集成层用真实依赖(测试容器/内存库);契约测试 |
其中一个数据点值得写进你的评审话术:Veracode 的 2025 GenAI 代码安全报告用 100 多个大模型生成代码并做安全测试,发现 45% 的测试场景中 AI 生成的代码引入了安全缺陷(Veracode 2025 GenAI Code Security Report,2025,retrieved 2026-09-05)。
AI 生成的业务代码尚且需要扫描,AI 生成的测试没有理由免检。
落到 CI 上的门禁清单(按 ROI 排序):
- 新代码行覆盖阈值(如 70%),只对增量生效,不动全库存量;
- 业务逻辑层变异分数阈值(如 60%),只对 70% 那一层开启;
- flaky 隔离队列:连续翻转的用例自动隔离 + 每周人工清理,重试次数设上限(重试不等于修复);
- AI 生成测试打标与抽检:PR 描述里声明 AI 生成比例,评审人至少抽检断言语义;
- 评审清单固定一问:这条测试挂了,我会知道什么坏了?答不上来的测试不应该合入。
Google Testing Blog 在《Code Coverage Best Practices》里的结论依然是最好的注脚:代码覆盖是”发现未测试代码的有用工具”,但高覆盖率远不等于测试有效,盲目追求覆盖率数字反而会激励低质量测试(Google Testing Blog,retrieved 2026-09-05)。
六周落地路线图
把前面的内容压进一张表,按周推进,每一步都有可度量的产出:
| 周次 | 动作 | 产出 | 度量指标 |
|---|---|---|---|
| W1 | CI 数据基线 + 选定试点模块 | 基线表、试点模块清单 | 三层分布、时长、flaky 率 |
| W2 | 单测产线跑通:prompt 模板 + 评审清单 | 试点模块 AI 生成测试合入 | 建议接受率(对照 Meta 的 73%) |
| W3 | 变异测试与覆盖门禁接入 CI | pitest/Stryker 报告 + 增量门禁 | 变异分数基线 |
| W4 | 集成层模板:环境骨架 + AI 用例矩阵 | 可复用的集成测试模板 | 集成用例数、该层 CI 时长 |
| W5 | UI 关键路径收敛 | 冒烟测试集 + flaky 隔离队列 | E2E 数量、flaky 率 |
| W6 | 复盘与推广机制 | 指标汇报、其他模块推广排期 | 缺陷逃逸率、单测执行时长 |
两条提醒:第一,全程盯缺陷逃逸率、变异分数、CI 时长、flaky 率这四个指标,不要盯”测试数量”——数量是唯一一个可以被 AI 无成本刷高的指标。第二,路线图能走多快取决于评审产能而不是生成产能,W2 的评审清单值得花一天时间打磨。
常见问题
AI 生成的测试能直接信任吗?
不能直接信任,但也不需要逐行从零审查。正确的流程是机器验证先过滤一轮——编译、运行、覆盖率比对、变异分数——再把幸存者交给人工评审断言语义。Meta 的经验是机器过滤后 73% 的建议可被接受,跳过机器过滤直接人审,效率会大幅下降。
覆盖率目标定多少合适?
分层设定:业务逻辑层新增代码行覆盖 70-80% 起步,配合变异分数趋势观察;不要设全库一刀切的阈值。覆盖率能帮你发现漏网之鱼,但回答不了”测试是否有效”——这也是 Google Testing Blog 反复强调的立场。
遗留代码完全没有测试,从哪开始?
不要从 E2E 开始补(那是把最贵的手段用在没有兜底的地方)。顺序是:高价值纯函数优先 → AI 生成特征测试固化现状 → 人工升级关键路径断言 → 重构。选择标准是”改这里最容易引入事故”,而不是”这里的代码最好写测试”。
70/20/10 是硬性规定吗?
不是。Google 官方文档原文就说各类测试占比”可能因应用的用例不同而异”,Mike Cohn 给的也是一个方向性框架。数字可以浮动,结构不能倒挂:单元测试永远应该占大头,UI 测试永远应该最克制。前端和全栈团队如果发现集成层占比天然更高,Kent C. Dodds 的 Testing Trophy(集成测试占最大比重)是更贴合的参考框架。
写在最后
回到开头的账:70/20/10 难落地,是因为手写测试的人力太贵;AI 把”写”的成本打下来了,落地就只剩下一个真问题——验证的产能。本文的路径可以压缩成三句话:用 CI 数据量出基线,让 AI 主攻金字塔底座,用变异测试和门禁守住”绿”的成色。
AI 不改变金字塔的形状,改变的是”谁在堆金字塔”:人从断言的作者变成断言的评审者。团队接入 AI 编码工具的具体工作流——包括怎么把验证环节嵌进 Agent 的执行循环——可以参阅此前的《Android CLI 与 Android Skills 最佳实践》。
你团队的测试分布现在是什么形状?欢迎在评论区贴出你的基线表,倒金字塔不可耻,看不见它才可耻。