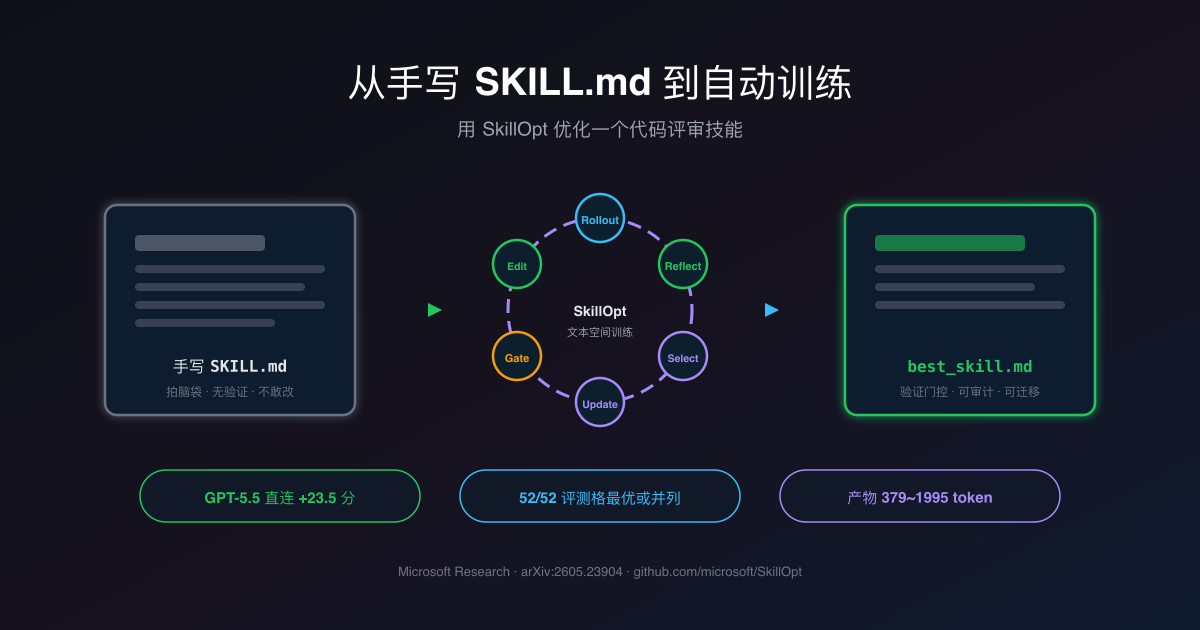
写 SKILL.md 的过程通常是这样:翻几个官方技能的写法,把团队经验归纳成 checklist,调几轮措辞,觉得”差不多”就发布了。这份技能到底让 agent 的评审能力变好了多少?写坏了会不会反而拖累表现?没人说得清。我在上一篇 Android Skills 实践里提过,android/skills 仓库的 22 个官方 SKILL.md 都有明确的工作流与约束,但”怎么验证自己写的技能真的有效”这个问题,当时没有答案。
Microsoft Research 今年 5 月开源的 SkillOpt 给了一个工程化的回答:把 SKILL.md 当作可训练参数,用一套复刻深度学习训练纪律的循环去优化它——有 epoch、有学习率、有验证集门控,但完全不碰模型权重。论文在 6 个基准、7 个模型、3 种执行方式组合评测的 52 个格子上全部取得最优或并列最优(直连模式 7 模型 × 6 基准共 42 格,Codex 与 Claude Code 两个 agent 环境下各评 GPT-5.5 的 5 个基准共 10 格),在 GPT-5.5 直连模式下把六基准平均分从 58.8 拉到 82.3(arXiv:2605.23904,2026-05-25 v2)。
本文基于 2026-09-21 核验的资料:论文 arXiv:2605.23904(v2)、GitHub 仓库 microsoft/SkillOpt(v0.2.0,2026-07-02 发布,MIT 协议)、Microsoft Research 官方博客(2026-07-24,检索于 2026-09-21)。前两节讲清方法与论文数据,后三节给出把代码评审任务接入 SkillOpt 的完整方案——论文的六个基准里没有代码评审,这一段是本文自己补上的。
Key Takeaways
- SkillOpt 把技能文档当作冻结 agent 的可训练外部状态,训练循环复刻深度学习:rollout 对应前向传播、分组反思对应反向传播、编辑预算对应学习率、验证门控对应验证集早停,全程不改模型权重。
- 论文在 52 个(模型 × 基准 × 环境)评测格上全部最优或并列最优,GPT-5.5 直连平均提升 +23.5 分;最终产物只有 379
1,995 token,由 14 条被接受的编辑构成。- 接入自有任务(如代码评审)需要自建四件套:数据加载器、带确定性 scorer 的 rollout、EnvAdapter、YAML 配置,参照官方示例约 200 行代码。
- 成本集中在训练期:论文中每提升 1 分需 0.6M~46.4M token;部署期零额外调用。没有标注数据时,可从历史 fix commit 反推样本,或用 SkillOpt-Sleep 从真实会话回放(注意隐私边界)。
一、SkillOpt 是什么:把 SKILL.md 当权重训练
论文对现有技能来源的批评很直接:手工编写靠经验、一次性 LLM 生成无反馈修正、松散的自修订循环则”看起来在改进,实际可能越改越差”——三种方式都没有深度学习优化器那种可复现的纪律。SkillOpt 的做法是把技能文档当成冻结模型的外部可训练状态:目标模型 M 保持不动,执行环境 h 对任务 x 产生轨迹 τ 和分数 r ∈ [0,1],优化器模型(一个单独的、通常更强的 LLM)负责改写技能文档。
训练前先把数据分成 train / selection / test 三份(论文默认 4:1:5,split_seed=42 固定随机种子):train 用来产生经验,selection 用来决定编辑是否被接受,test 只在最终报告时使用。整个循环长这样:
几个关键机制的对应关系,官方文档给了一张直白的对照表:
| 深度学习 | SkillOpt |
|---|---|
| 模型权重 | 技能文档(Markdown) |
| 前向传播 | Rollout:目标模型执行任务 |
| 损失 / 梯度 | Reflect:优化器从轨迹产出编辑补丁 |
| 梯度裁剪 | 编辑选择:learning_rate = 每步最多编辑条数 |
| SGD 一步 | 补丁应用到技能文档 |
| 验证集 | 在 selection 划分上的门控评估 |
| 学习率调度 | lr_scheduler:cosine / linear / constant |
| Epoch | 多轮训练 + slow update 与 meta skill |
真正把这套循环和”让 LLM 自己改自己的 prompt”区分开的,是两个设计。验证门控:候选技能只有在 selection 划分上严格超过当前分数才会被接受——平局也算失败,部署产物永远不会悄悄变差。rejected-edit buffer:被拒的编辑不是扔掉,而是连同”它导致分数降了多少”一起记进本轮的负反馈池,后面的反思轮次会看到这些失败尝试,避免重复踩坑。论文的评价是:看似合理的文字诊断也可能伤害实际模型,门控把反思从”无条件自我编辑”变成了 propose-and-test 优化。
二、论文数字:提升多大,代价几何
直接看主结果。GPT-5.5 直连模式下,六个基准从”无技能”到”SkillOpt 训练后”:
把论文的结论压缩成几句话:
- 全面性:6 个基准(SearchQA、SpreadsheetBench、OfficeQA、DocVQA、LiveMathematicianBench、ALFWorld)、7 个目标模型(GPT-5.5 到 Qwen3.5-4B)、3 种执行模式(直连、Codex CLI、Claude Code CLI)组合出 52 个评测格——直连模式评满 7×6=42 格,两个 agent 环境各评 GPT-5.5 的 5 个基准(ALFWorld 需要持久环境交互,不进 harness 模式)共 10 格——全部最优或并列最优;对手包括人写技能、一次性 LLM 生成、Trace2Skill、TextGrad、GEPA、EvoSkill 六类基线(Table 1)。GPT-5.5 直连下,SkillOpt 比一个”每格都挑最强基线”的 oracle 还高 +5.4 分(82.3 vs 76.9,Table 1)。
- 环境增益:GPT-5.5 在 Codex 智能体循环内平均 +24.8 分,在 Claude Code 内 +19.1 分(Table 1)。论文的 Codex/Claude Code harness 会把当前技能渲染成每个任务的 SKILL.md 放进工作区,并回读执行轨迹摘要参与反思——和你日常把技能喂给 coding agent 的方式是同一件事。
- 小模型受益更明显:七个直连模型的平均增益为 GPT-5.5 +23.5、GPT-5.4 +12.7、GPT-5.4-mini +15.4、GPT-5.4-nano +26.7、GPT-5.2 +16.6、Qwen3.5-4B +19.2、Qwen3.6-35B-A3B +9.1(Table 1,总体均值约 +17.6)。Qwen3.5-4B 在 SpreadsheetBench 上从 9.3 提到 23.9(×2.6)——一份几百 token 的技能文档,能补上小模型权重里缺的程序性知识。
- 产物小得反直觉:六个基准的最终 best_skill.md 在 379
1,995 token 之间(中位约 920),且只由 14 条(中位 2.5)被门控接受的编辑构成。LiveMathematicianBench 的 +29.3 分和 OfficeQA 的 +39.0 分,各自来自一条编辑。作为对照基线的专家手写技能有 145516 token,在直连模式下每一行都被 SkillOpt 击败——注意区分口径:下文成本表里 16516 的初始 token 是 SkillOpt 自己的种子技能,可以短到一行。 - 消融证明机制有效(Table 2 / Table 3):去掉 meta skill 和 slow update,SpreadsheetBench 从 77.5 跌到 55.0(-22.5,Table 3);去掉 rejected-edit buffer,三个消融基准分别 -1.6/-4.6/-2.4(Table 3);把编辑预算从 1 扫到 16 都比”无预算自由改写”强(Table 3,无预算行为在三个消融基准上为 84.6/75.7/57.3;Table 2 是预算与调度的扫描)。换句话说,有界更新和门控本身就在起作用,而不是某组精调的超参。
成本方面(Table 6,GPT-5.5 学生 + GPT-5.5 优化器):
| 基准 | 初始 token | 最终 token | 接受编辑数 | 训练 token | 每提升 1 分 |
|---|---|---|---|---|---|
| SearchQA | 16 | 857 | 4 | 213.8M | 37.9M |
| SpreadsheetBench | 224 | 1,995 | 4 | 21.4M | 0.6M |
| OfficeQA | 145 | 883 | 1 | 20.8M | 1.1M |
| DocVQA | 81 | 959 | 3 | 188.2M | 46.4M |
| LiveMathematicianBench | 154 | 379 | 1 | 23.2M | 3.6M |
| ALFWorld | 516 | 1,321 | 2 | 59.3M | 15.9M |
规律很清楚:轨迹短、任务程序性强的基准便宜(每分 0.6M~3.6M token),轨迹长或多模态的基准贵一个量级(SearchQA 37.9M/分、DocVQA 46.4M/分)。这些钱都花在训练期——部署后的 best_skill.md 对目标模型零额外调用。这对设计自有任务的启示放到第四节讲。
另外两个值得记住的迁移实验(Table 4):在 Codex 里训出来的 SpreadsheetBench 技能拿到 Claude Code 里跑,从 22.1 拉到 81.8(+59.7),甚至略高于 Claude Code 原生训练的 80.4——说明学到的是”先看工作簿结构再动手”这类程序性纪律,不是某个 harness 的命令配方;在 GPT-5.4 上训的技能迁移到 GPT-5.4-mini,保留了 82% 的域内增益(Table 4)。技能产物是一次训练、多处复用的。
最后看看训练出来的是什么东西。论文 Figure 4 摘录了几条 verbatim 规则,比如 SpreadsheetBench 学到:”先检查工作簿结构与公式,再把求值后的静态值写入完整目标区间,而不是依赖 Excel 重算”;OfficeQA 学到:”把 oracle 解析页作为一手证据,锁定表格/日期/单位上下文,按要求的舍入精度输出,不带多余标签”。都是程序性纪律——不点名任何具体题目、文件或实体,更像一个老手工程师泡了一天任务后写下的经验帖,只不过它们是被优化器从失败轨迹里挖出来、再逐条过验证门的。
三、接入自有任务:SkillOpt 的四件套契约
SkillOpt 内置的六个基准离代码评审都远,但官方扩展文档把接入自定义任务的路径写得很清楚:实现一个 benchmark 约需要四个文件(官方叫 docfaithful 的教学示例约 200 行),仓库里还有 officeqa、swebench(main 分支注册表里已有,比论文六基准更贴代码场景)等完整实现可以抄。
四件套的分工:
SplitDataLoader子类:把 train/val/test 目录里的样本读成统一的 dict 列表;- rollout 辅助函数:让目标模型带着当前技能执行任务、打分并持久化对话——scorer 就住在这里,框架没有单独的
evaluate()方法; EnvAdapter子类:把前两者接进训练生命周期(build_train_env/build_eval_env/rollout/get_task_types四个抽象方法);- YAML 配置:声明环境名、种子技能路径和训练超参。
其中最难的不是代码,是数据集和 scorer 的设计。代码评审的样本就是”一段 diff + 它已知的问题清单”,三个靠谱来源:
- 仓库自己的 fix commit:把修复提交 diff 掉依赖部分,缺陷标注就是 commit message 和修复内容反推出来的”修复前有什么问题”。自家的历史 bug 天然贴近真实评审场景。
- 注入缺陷:在干净代码上按类别(空指针、并发、资源泄漏、生命周期泄漏)注入已知缺陷,标注完全可控。
- 公开数据集:CodeReviewer、SWE-bench 类数据的评审子集,拿来冷启动。
规模上,论文的程序性基准用了几十到几百条训练样本,个人团队从 100~200 条起步是现实的。scorer 必须确定性、可复现——官方文档原话:”Noisy scoring kills the optimizer. Spend time on run_batch’s scoring before you spend time on prompts.”(噪声评分会杀死优化器,先把打分做扎实再琢磨提示词。)对代码评审,”命中”可以定义为:评审意见同时包含缺陷的锚点(函数名/变量名等可定位字符串)和类别(空指针/并发/资源泄漏……);hard 分数要求全部真缺陷命中,soft 分数用召回率给部分分。误报惩罚(评审意见里的假缺陷扣分)可以加进 soft,但第一版建议保持简单,先让循环跑通。
四、三步搭起来:codereview 环境完整代码
第 1 步:安装与目录
1 | git clone https://github.com/microsoft/SkillOpt.git |
后端配置注意一点:claude_chat 后端实际是拉起 claude -p 命令行,不是直连 Anthropic API;如果你的 provider 兼容 OpenAI Chat 协议,优先用内置的 openai_compatible 后端,不用写任何集成代码。
第 2 步:数据加载器与 rollout(scorer 在这里)
1 | # skillopt/envs/codereview/dataloader.py |
1 | # skillopt/envs/codereview/rollout.py |
两个官方强调过的坑写进代码注释了:conversation.json 必须持久化(共享反思阶段按 predictions/<id>/conversation.json 读取,缺了就跳过该样本——训练反复报 skip_no_patches 十有八九是它);走 chat_target 而不是裸调 API,这样后端切换对适配器透明。
第 3 步:Adapter、注册与配置
1 | # skillopt/envs/codereview/adapter.py |
在 scripts/train.py 的 _register_builtins() 里加四行(scripts/eval_only.py 同样处理),否则会报 ValueError: Unknown environment 'codereview':
1 | try: |
1 | # configs/codereview/default.yaml |
种子技能就是你现在手写的那份 SKILL.md 正文,比如:
1 | # 代码评审技能(手写种子版) |
训练与评估:
1 | # 调试期先小步快跑:batch_size=4、只取 10 条样本 |
跑起来之后,输出目录的每个文件都有用途:best_skill.md 是部署产物;history.json 记录每一步的门控决策;skills/skill_vXXXX.md 是技能快照;steps/step_XXXX/ 里有 edit_apply_report.json,每条编辑的接受/跳过状态都在,事后可审计;runtime_state.json 支持断点续跑(重跑同一命令会从上次中断的 step 继续)。想看训练曲线可以起 WebUI:python -m skillopt_webui.app(Gradio,默认 7860 端口)。
成本预估:按论文的成本表倒推,代码评审 rollout 是单轮短轨迹(类似 OfficeQA 的 1.1M token/分),100 条样本 × 4 epoch × 每步一次 val 评估,整体量级在千万级 token 以内,训练期费用可控。超出预算时优先砍 epoch 数和 rollout batch,别砍 scorer 质量。
五、拿到 best_skill.md 之后
先读产物再部署。 打开 history.json 和 edit_apply_report.json,看优化器提了哪些编辑、被门控拒了哪些、为什么。论文的经验是大量提案会被拒(六个基准最终只接受 1~4 条),被拒的提案恰恰是”听起来合理但实际伤分”的改动——这份负反馈清单本身就是免费的质量工程材料,值得抄进团队评审规范。
部署就是包一层 frontmatter。 把 best_skill.md 正文放进项目的 .claude/skills/code-review/SKILL.md:
1 | --- |
这与论文里 Claude Code harness 的用法一致——它就是把当前技能渲染成 SKILL.md 放进任务工作区。上次说过的 harness 选择问题(Codex 与 DeepSeek harness 对比)在这里同样成立,而且论文给了底气:同一份 best_skill.md 在 Codex 和 Claude Code 之间迁移是正收益的(SpreadsheetBench 跨 harness 迁移 +59.7/+43.6),你的技能资产不用绑定单一工具链。
让训练变成日常而非一次性项目。 v0.2.0 新增的 SkillOpt-Sleep 把这套纪律搬到了部署侧:夜间”睡眠循环”读取你本地 Claude Code / Codex / Copilot / Cursor 的历史会话,挖掘反复出现的任务,用你自己的 API 预算回放,然后反思、有界编辑、过 held-out 验证门控,产出待你人工采纳的技能/记忆更新提案(harvest → mine → replay → consolidate → stage)。这基本就是”从真实使用中自动训练技能”的完整闭环,对个人开发者是最省力的入口。两点提醒:它是 preview 状态,接口会变;数据边界要清楚——真实后端会把会话摘录发给所选 provider,敏感项目先走”harvest 落盘 → 人工审查脱敏 → 标记 "reviewed": true 再回放”的流程。
六、工程判断:什么时候值得训
不是所有技能都值得进训练循环。三个条件都满足再动手:
- 有确定性 scorer。代码评审有”缺陷是否被指出”这样的硬信号;纯主观的文风类技能没有,硬训只会把噪声当梯度。
- 失败模式是程序性的。论文里提升最大的基准(SpreadsheetBench +38.9、OfficeQA +39.0)共性是:模型缺的是”先看结构再写值””按格式输出”这类纪律。如果你的 agent 评审老是漏掉并发问题、格式总是不符合团队规范,这是可训练的;如果问题是”业务理解不到位”,技能文档解决不了。
- 样本够、轨迹短。百条量级样本、单轮或浅多轮任务成本可控;长轨迹任务(论文里 SearchQA 每分 37.9M token)先把轨迹砍短再训。
反过来说,手写不是被淘汰,而是换了角色:手写版做种子(skill_init),训练循环在它基础上做有界增强,验证门控保证不回退——最差情况也只是回到你的手写版。论文对 learned rules 的定性观察(程序性、非实例化、像老手写的经验帖)说明这门”训练”补的正是手写最难补的那部分:从大量真实失败里归纳、且经过数据验证的纪律。
对团队,我的建议是三步走:先用 SkillOpt-Sleep 对现有会话做一次免费诊断(mock 后端不花钱,还能看到它想提什么编辑);再从 fix commit 攒 100 条代码评审样本跑一个小规模训练(batch_size=4 起步);最后把 best_skill.md 进 code review,拿一个季度的真实评审数据回填样本库,进入下一轮训练。这套”基线—回归—回填”的循环,和《AI 生成的单元测试:70/20/10 测试金字塔怎么落地》里对测试套件的做法是同一个思路:先有可测量的基线,再谈优化。技能从此从”文档”变成”有版本、有回归验证、可回滚的工程资产”。
FAQ
SkillOpt 会修改模型权重吗?
不会。目标模型全程冻结,优化只发生在技能文档上。部署产物是一个几百到两千 token 的 Markdown 文件,推理时零额外模型调用——这也是它区别于微调(LoRA/全参)的根本点:不占 GPU 训练资源,产物可读、可审计、可跨模型复用。
它和 TextGrad、GEPA、DSPy 这类提示词优化有什么区别?
论文的实验设计刻意做了隔离:目标模型、执行环境、评分器全部固定,只换适配方法。TextGrad/GEPA 优化的是”某次调用的 prompt”,没有持久的技能产物,也没有 held-out 门控——它们在论文里是被 SkillOpt 全面超过的基线。DSPy 走声明式管线编译路线,解决的问题不同。一句话:SkillOpt 优化的是可部署、可迁移的技能文件,并把深度学习的训练纪律(编辑预算、验证门控、负反馈、slow update)带进了文本空间。
没有标注好的缺陷清单,还能训代码评审技能吗?
能,但必须有可验证信号,否则退化为噪声优化。三条路:从仓库历史 fix commit 自动反推标注(修复 diff 就是答案);按类别注入缺陷自造标注;或用 SkillOpt-Sleep 从真实会话回放并人工审核任务集。核心原则不变——scorer 要确定性,哪怕粗(命中/未命中二值)也比模糊的”评审质量打分”有效。
优化器用多大的模型?训练贵不贵?
优化器只在训练期运行,不进部署,所以”有更强的就用更强的”——论文 Table 5 显示强优化器在所有测试格上增益更大,目标模型自任优化器只能恢复 56%74% 的增益。成本参考 Table 6:短轨迹程序性任务每提升 1 分约 0.6M3.6M token,长轨迹或多模态任务 15M~46M token。个人场景把 rollout batch 和 epoch 压小(batch_size=4、epochs=2),总开销可以压到百万 token 量级。
结语
SkillOpt 把一个一直靠手感的事情变成了工程问题:技能文档 = 可训练参数,训练 = 有门控的文本空间优化,产物 = 小到可以通读的 Markdown。对每天在给 agent 写 SKILL.md 的工程师,值得动手的顺序是:选一个有硬信号的任务(代码评审就很合适)→ 攒 100 条样本 → 按 docfaithful 的四件套契约写 200 行适配代码 → 用 batch_size=4 跑第一次训练。当你第一次看到 history.json 里”提案被拒、分数不回退”的记录时,你会意识到技能维护这件事已经有了回归测试。
项目地址:microsoft/SkillOpt(MIT,PyPI 包名 skillopt),论文:arXiv:2605.23904,官方博客:SkillOpt: Agent skills as trainable parameters。关于 SKILL.md 本身的写法约定,见上一篇:Android CLI 与 Android Skills 最佳实践。