端侧 AI 正在从”能跑起来的 demo”迈向”可量产的产品”。这两者之间的鸿沟,远比想象中宽阔:模型怎么分发与校验、推理引擎如何利用 NPU、长对话的 KV Cache 怎么持久化、本地模型如何安全地调用系统功能——每一层都是工程问题。
Google 的 AI Edge Gallery 是目前最值得研究的参考实现。截至 2026-08-20,这个 24.5k stars 的开源项目(Apache 2.0,Kotlin 编写)不是一个玩具 demo,而是 Google 开源的端侧 AI 参考实现——其底层推理引擎 LiteRT-LM 同时驱动着 Chrome、Chromebook Plus 和 Pixel Watch 的生产级端侧 AI 体验。Google 产品经理 Alice Zheng 在官方访谈中透露,该应用上线首月模型下载量即超过 500 万次(YouTube 官方访谈,2026-06)。它把从模型下载、推理加速、Function Calling 到 Agent MCP 协议的全链路都做到了可运行、可复刻的程度。
本文基于 2026 年 8 月的 GitHub 仓库(最新更新 2026-08-20)与 Google 官方技术博客,自底向上拆解这套架构,提炼可直接借鉴的工程模式。
核心要点
- 三层架构清晰分工:LiteRT(底层推理引擎,TFLite 继任者)→ LiteRT-LM(LLM 编排层,会话管理 + KV Cache 序列化 + MTP)→ Gallery App(Kotlin 应用层),每层职责独立、可单独复用。
- 模型管理工程化:通过
model_allowlistsJSON 声明模型元数据(大小、最低内存、加速器、任务类型),App 按设备能力筛选可运行模型,避免 OOM。- Function Calling 端侧闭环:
@Tool/@ToolParam注解 + FunctionGemma 270M 微调模型 + 两条执行路径(JavaScript Skills 与 Native App Intents),实现纯离线的自然语言设备控制。- MCP 让端侧 Agent 突破沙箱:通过 Streamable HTTP 动态导入工具定义到系统 prompt,本地推理决策 + 远程 MCP 执行的混合架构,兼顾隐私与能力扩展。
项目定位与技术全景
AI Edge Gallery 的 GitHub 仓库简介写得很直接:”A gallery that showcases on-device ML/GenAI use cases and allows people to try and use models locally”。但它真正的价值不在于”展示”,而在于它是一套生产级端侧 AI 技术栈的完整开源参考。
关于 AI Agent 接入可验证的 Android 开发流程 的实践此前已有讨论,而 AI Edge Gallery 展示的是另一条路径:不是让 Agent 调用 App,而是让 App 本身成为 AI 运行时。
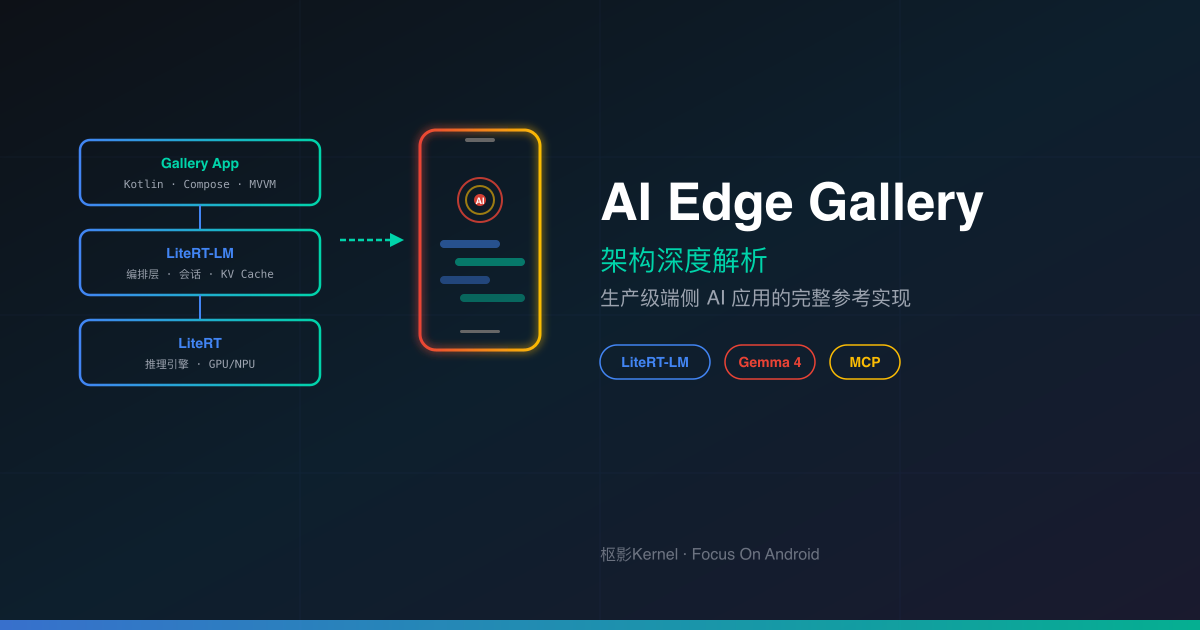
整个技术栈分三层,自底向上依次是:
理解了这个分层,就能把握 Gallery 的核心设计哲学:把推理复杂性下沉到 C++ 引擎层,把 LLM 专用逻辑收敛到编排层,应用层只关心业务。这意味着开发者可以按需取用——只需要推理能力就集成 LiteRT,需要完整 LLM 会话就引入 LiteRT-LM,需要参考 Agent 架构就研究 Gallery App 源码。更多 Android 效率工程与 AI Agent 工具化实践 的内容,可参阅此前的 Android CLI 文章。
推理引擎层:LiteRT 与 LiteRT-LM 的分工
端侧 LLM 推理的工程难度集中在两点:算力利用和内存效率。Gallery 用两层来分别解决。
LiteRT:底层推理引擎
LiteRT 是 TensorFlow Lite 的继任者,Google 在 官方文档 中将其定位为”on-device framework for high-performance ML & GenAI deployment on edge platforms”。它是一个 C++ 核心,负责把量化后的模型(通常 int4)映射到设备的 GPU 或 NPU 上执行。它的跨平台抽象让同一份模型文件能在 Android、iOS、桌面甚至 Raspberry Pi 上运行。
LiteRT-LM:LLM 专用编排层
LiteRT 解决通用 ML 推理,但 LLM 有自己的特殊需求——会话状态、KV Cache、流式输出、工具调用。这些由 LiteRT-LM 编排层处理。Google 在 开发者博客 中称其为”production-ready orchestration layer to run LLMs with LiteRT”。
LiteRT-LM 的 Kotlin API 设计得相当干净,核心是 Engine → Conversation 两级模型:
1 | import com.google.ai.edge.litertlm.* |
这段代码展示了 Gallery 底层调用的核心路径:Engine 管理模型生命周期,Conversation 管理单次对话上下文,sendMessageAsync 返回 Flow<String> 实现流式输出。SamplerConfig 暴露了 topK/topP/temperature 三个核心采样参数——Gallery 的 Prompt Lab 功能正是基于这些参数构建的。
性能数据:MTP 带来的飞跃
LiteRT-LM 近期引入的 Multi-Token Prediction(MTP) 是一项关键优化。传统自回归模型一次只生成一个 token,MTP 允许一次预测多个 token,据 Google 官方博客介绍,MTP 在 GPU 后端上可使 Gemma 4 模型推理速度提升至 3 倍。
根据 Google 官方基准数据(访问于 2026-08-20),Gemma 4 E2B 模型的表现如下:
这组数据揭示了端侧推理的现状:Prefill 速度极快(现代手机 GPU 可达 3000+ tk/s),但 Decode 速度仍是瓶颈(52-57 tk/s)。这也是 Gallery 强调会话恢复能力的原因——快速 prefill 让”重新加载长对话上下文”变得几乎无感。
模型管理:从 Hugging Face 到设备本地
Gallery 面临的第一个工程问题是模型分发。一个 int4 量化的 Gemma 4 E2B 模型约 2.58 GB,E4B 约 3.65 GB——不可能打包进 APK,必须运行时下载。而不同设备的内存和算力差异巨大,不能让用户下载一个跑不动的模型。
model_allowlists:声明式模型注册
Gallery 的解法是 model_allowlists JSON——一份声明式的模型清单,每个模型条目包含完整的元数据。以 Gemma 3n E2B(约 3.16 GB)为例:
1 | { |
这个设计有几个值得借鉴的工程决策:
设备能力门控。minDeviceMemoryInGb 字段让 App 在展示模型列表前先检测设备内存,过滤掉无法运行的模型,避免用户下载 4GB 模型后 OOM 崩溃。accelerators 字段声明模型支持的加速器类型,App 据此选择最优后端。
模型版本追踪。commitHash 绑定 Hugging Face 仓库的特定 commit,确保下载的模型文件可追溯、可复现。这对于排查”模型行为变化”类问题至关重要。
任务类型映射。taskTypes 声明模型适用于哪些功能(chat、prompt_lab、ask_image、ask_audio),bestForTaskTypes 标注最优场景。这让 App 能为不同任务推荐最合适的模型——比如多模态任务优先推荐支持图像/音频的模型。
下载与加载流程
ModelManagerViewModel(Gallery 源码中的核心组件)负责编排整个下载-验证-加载流程:从 Hugging Face 通过 modelId 拉取 .litertlm 文件,存入 externalFilesDir,校验文件大小与 commitHash,最后交给 LiteRT-LM 引擎初始化。用户也可以直接粘贴 Hugging Face 模型卡片 URL 导入自定义模型——这是 Gallery 对社区模型生态的开放姿态。
值得注意的是模型格式之争。Gallery 早期使用 MediaPipe LLM Inference API 的 .task 格式,后逐步迁移到 LiteRT-LM 的 .litertlm 格式。前者通过 MediaPipe Tasks 封装,后者直接对接 LiteRT-LM Engine。从 model_allowlists 的演进看,新模型已统一采用 .litertlm,.task 格式主要保留给旧模型兼容。
下面的实操演示视频展示了从模型下载到多模态对话的完整体验,可以直观感受端侧推理的实际速度:
Function Calling 架构:让本地模型调用系统功能
端侧 LLM 如果只能聊天,价值有限。真正让 Gallery 从”聊天 demo”升级为”Agent 平台”的,是其 Function Calling 架构——让本地模型理解自然语言指令,生成结构化函数调用,执行设备操作。
注解驱动的工具声明
Gallery 的 Function Calling 指南 展示了一套注解驱动的工具声明机制。开发者定义 ActionType 枚举标注可用操作类型,用 @Tool 和 @ToolParam 注解描述工具的入参与语义:
1 | // 定义操作类型枚举 |
这套注解会被编译处理,生成工具的 schema 描述注入到模型的系统 prompt 中。当用户说”帮我设一个明天早上 7 点的闹钟”时,模型根据 schema 生成包含 ActionType.SET_ALARM 和具体参数的 JSON 调用,App 的 performAction handler 据此执行实际操作。
FunctionGemma 270M:专为工具调用微调的小模型
Gallery 的 Mobile Actions 功能背后不是 Gemma 4,而是一个专门的 FunctionGemma 270M 微调模型。这是一个只有 2.7 亿参数的超小模型,专门为结构化输出和函数调用微调。它的存在说明一个重要的工程取舍:工具调用不需要大模型的推理能力,需要的是可靠的 JSON 输出。用 270M 小模型替代 2B/4B 大模型做工具调用,既省内存又快。
Tiny Garden 小游戏是这种能力的趣味展示:玩家用自然语言”在第一行种向日葵并浇水”,270M 模型将其分解为 plantCrop 和 waterCrop 两个函数调用,带上网格坐标参数,驱动游戏逻辑——全程离线,无一次服务器请求。
两条执行路径
Gallery 的 Agent Skills 支持两条执行路径,体现对”工具”的广义理解:
JavaScript Skills:自定义逻辑运行在隐藏的 WebView 中,可访问完整的 Web 生态——fetch() 请求、CDN 库、甚至 WebAssembly。这让 Agent 能执行如”查询 Wikipedia”这类需要网络请求的任务,同时保持在 App 沙箱内。
Native App Intents:利用 OS 内建能力,目前支持发送邮件和短信,可通过扩展源码添加更多。这条路径直接调用 Android 系统 API,延迟最低。
关于端侧 AI 与 Agent 工具化实践 的更多内容,可参阅此前 AppFunctions 框架一文——两者在”让 App 能力可被 AI 调用”这个方向上殊途同归。
MCP 集成:端侧 Agent 的工具协议
Function Calling 解决了”调用 App 内部功能”的问题,但 Agent 的能力往往需要突破 App 沙箱——查询日历、读取邮件、操作外部服务。Gallery 的答案是集成 Model Context Protocol(MCP)。
混合架构:本地决策 + 远程执行
Gallery 的 MCP 集成采用 Streamable HTTP 传输,架构是一个精心设计的混合体:
关键在于分工:用户注册一个 MCP URL 后,App 动态拉取该 server 暴露的工具定义和资源 schema,注入到本地 Gemma 4 的系统 prompt 中。当用户提问时,模型在设备本地完成推理和决策——“这个请求需要调用哪个工具”——生成函数调用后,请求才发送给 MCP server 执行。
这种设计把最敏感的环节(推理过程、用户 prompt、模型上下文)留在设备上,只有最终的工具调用请求走网络。相比把整个对话发给云端 Agent,这个架构在隐私和能力之间找到了平衡点。官方博客举的例子很直观:连接 Google Workspace MCP 后,手机上的 Gemma 4 能查询你的日历事件或检查收件箱——推理在手机上完成,只是查询请求发给了 MCP server。
会话连续性与多模态
端侧 AI 应用的用户体验,很大程度上取决于会话管理的工程质量。Gallery 在这方面的实现基于 LiteRT-LM 的原生能力。
KV Cache 序列化:会话恢复的秘密
长对话的”冷启动”一直是端侧 LLM 的痛点——重新加载几千 token 的历史上下文,传统做法要重新 prefill 整个序列,耗时数秒。LiteRT-LM 的解法是 KV Cache 原生序列化:把模型内部的 Key-Value 缓存状态(代表已处理的上下文历史)序列化保存,恢复会话时直接加载,跳过 prefill 阶段。
Google 在 LiteRT-LM 技术博客 中解释了这套机制的工程价值:保存上下文状态减少了重复计算,绕过了返回会话时的重型 prefill 阶段。配合现代手机 GPU 3000+ tk/s 的 prefill 速度,即使需要重新 prefill,长会话恢复也几乎无感。
Gallery 据此实现了持久化聊天历史——支持文本、图像、音频输入的完整会话状态保存与恢复。用户中断对话后回来,之前的上下文、发过的图片、录过的音频都在。
多模态:文本 + 图像 + 音频
Gallery 的多模态支持覆盖三种输入:文本聊天、图像理解(Ask Image)、音频转录(Audio Scribe)。这依赖 Gemma 4 模型的多模态能力——E2B 和 E4B 变体支持图像和音频输入,能处理视觉谜题、识别物体、转录语音。
模型的多模态能力在 model_allowlists 中通过 llmSupportImage 和 llmSupportAudio 两个字段声明,App 据此决定是否在对应功能入口展示该模型。这种声明式设计让多模态支持与模型管理解耦——新增一个支持视频的模型,只需在 JSON 中加一个字段,不需要改 App 代码。
官方访谈视频中,Google 产品经理 Alice Zheng 演示了两个典型多模态场景——离线解释”天空为什么是蓝色”和用音频输入生成结构化购物清单:
对开发者的参考价值与借鉴
AI Edge Gallery 的价值不止于一个可用的 App,更在于它提供了一套可复刻的端侧 AI 工程模板。以下是最值得借鉴的架构模式:
如何在自己项目中复用:如果只需要端侧推理能力,直接集成 LiteRT-LM 的 Kotlin 或 Swift API,几行代码就能跑起 Gemma 模型。如果需要模型管理参考,clone Gallery 仓库研究 ModelManagerViewModel 和 model_allowlists 的实现。如果要构建 Agent,重点研究 Function Calling 指南和 MCP 集成的源码——这两块是市面上少有的端侧 Agent 生产级参考。
一个容易被忽视的借鉴点是小模型专精化。Gallery 用 270M 的 FunctionGemma 做工具调用,而不是用 2B/4B 的 Gemma 4,体现了”用最合适的模型做最合适的任务”的工程思维。在自己的端侧 AI 项目中,把推理、工具调用、安全过滤等任务分给不同大小的专用模型,往往比用一个通才大模型更高效。
常见问题
AI Edge Gallery 支持哪些设备和模型?
Android 12 及以上、iOS 17 及以上。模型方面,官方支持 Gemma 4 E2B/E4B、Gemma 3n E2B/E4B、Gemma 3 1B/4B 等,均可从 Hugging Face LiteRT Community 下载。也支持通过模型卡片 URL 导入兼容的自定义模型。设备需满足模型的 minDeviceMemoryInGb 要求(E2B 至少 8GB,E4B 至少 12GB)。
LiteRT-LM 和 MediaPipe LLM Inference API 是什么关系?
两者都是 Google AI Edge 体系的端侧 LLM 推理方案。MediaPipe LLM Inference API 是较早的方案,使用 .task 格式,通过 MediaPipe Tasks 封装。LiteRT-LM 是更新的编排层,使用 .litertlm 格式,直接对接 LiteRT 引擎,原生支持会话管理、KV Cache 序列化、MTP 和 Tool Use。AI Edge Gallery 正在从 MediaPipe 方案向 LiteRT-LM 迁移,新模型优先采用 .litertlm。
MCP 集成需要联网吗?
需要。MCP 工具的执行通过 Streamable HTTP 连接远程 MCP server,这一步需要网络。但关键的推理和决策环节——模型读取用户 prompt、理解 MCP 工具 schema、决定调用哪个工具、生成函数调用——全部在设备本地完成。只有最终的工具执行请求走网络。如果不需要 MCP 工具,纯聊天和 Function Calling 完全离线。
普通 Android 开发者如何开始?
三条路径:一是直接下载 AI Edge Gallery 体验功能;二是 clone GitHub 仓库 研究源码,重点看 ModelManagerViewModel 和 Function Calling 相关实现;三是直接集成 LiteRT-LM 到自己的项目,用几行 Kotlin 代码跑起端侧推理。官方还提供了 Function Calling 指南,手把手教你在自己的 App 中实现工具调用。更多端侧 AI 与 Agent 工具化框架解析 的内容,可参阅 AppFunctions 框架一文。
结论
AI Edge Gallery 的架构解析到这里,一个清晰的图景浮现出来:端侧 AI 的生产级实现,不是把一个模型塞进 App 这么简单,而是一套从引擎层到应用层的系统工程。
回顾要点:
- 三层架构:LiteRT 推理引擎 → LiteRT-LM 编排层 → Gallery 应用层,每层职责独立、可单独集成。
- 工程化决策:声明式模型管理(JSON 元数据 + 设备门控)、注解驱动工具系统(
@Tool+ 小模型专精)、MCP 混合 Agent 架构(本地决策 + 远程执行)。 - 性能关键:MTP 多 token 预测提升解码速度、KV Cache 序列化实现会话无感恢复、int4 量化控制模型体积。
- 开放生态:Apache 2.0 全开源,Hugging Face 模型导入,MCP 标准协议接入,社区 Skills 扩展。
对于关注端侧 AI 的 Android 开发者,这个仓库是当前最完整的生产级参考。不是每个项目都需要从头实现这些——但理解这套架构的分层逻辑和工程取舍,能让你在面对自己的端侧 AI 需求时,知道哪些该自研、哪些该复用、哪些该等待生态成熟。
端侧 AI 的基础设施正在快速成型,Google 把自己的生产技术栈开放出来,既是示范也是邀约。趁早研究这套参考实现,是在为未来的端侧 AI 产品积累架构判断力。